Kafka 怎么保证消费只消费一次的?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
- 消息语义的掌握度:面试官不仅仅想知道你知不知道“只消费一次”这个词,更想知道你是否清楚 At Most Once、At Least Once、Exactly Once 三种语义的区别,以及 Kafka 默认给的是哪一种。
- 对重复消费根因的理解:是否明白重复的根源在于“业务处理与 offset 提交不是原子操作”,而不是只会背几个配置项。
- 方案设计能力:能否结合实际业务给出幂等性设计(唯一索引、去重表、Redis、状态机),这是区分“背题的”和“干过活的”的关键。
核心答案
先说结论:Kafka 默认只能保证 At Least Once(至少一次,不丢但可能重复),“只消费一次”需要开发者在消费端做额外设计。
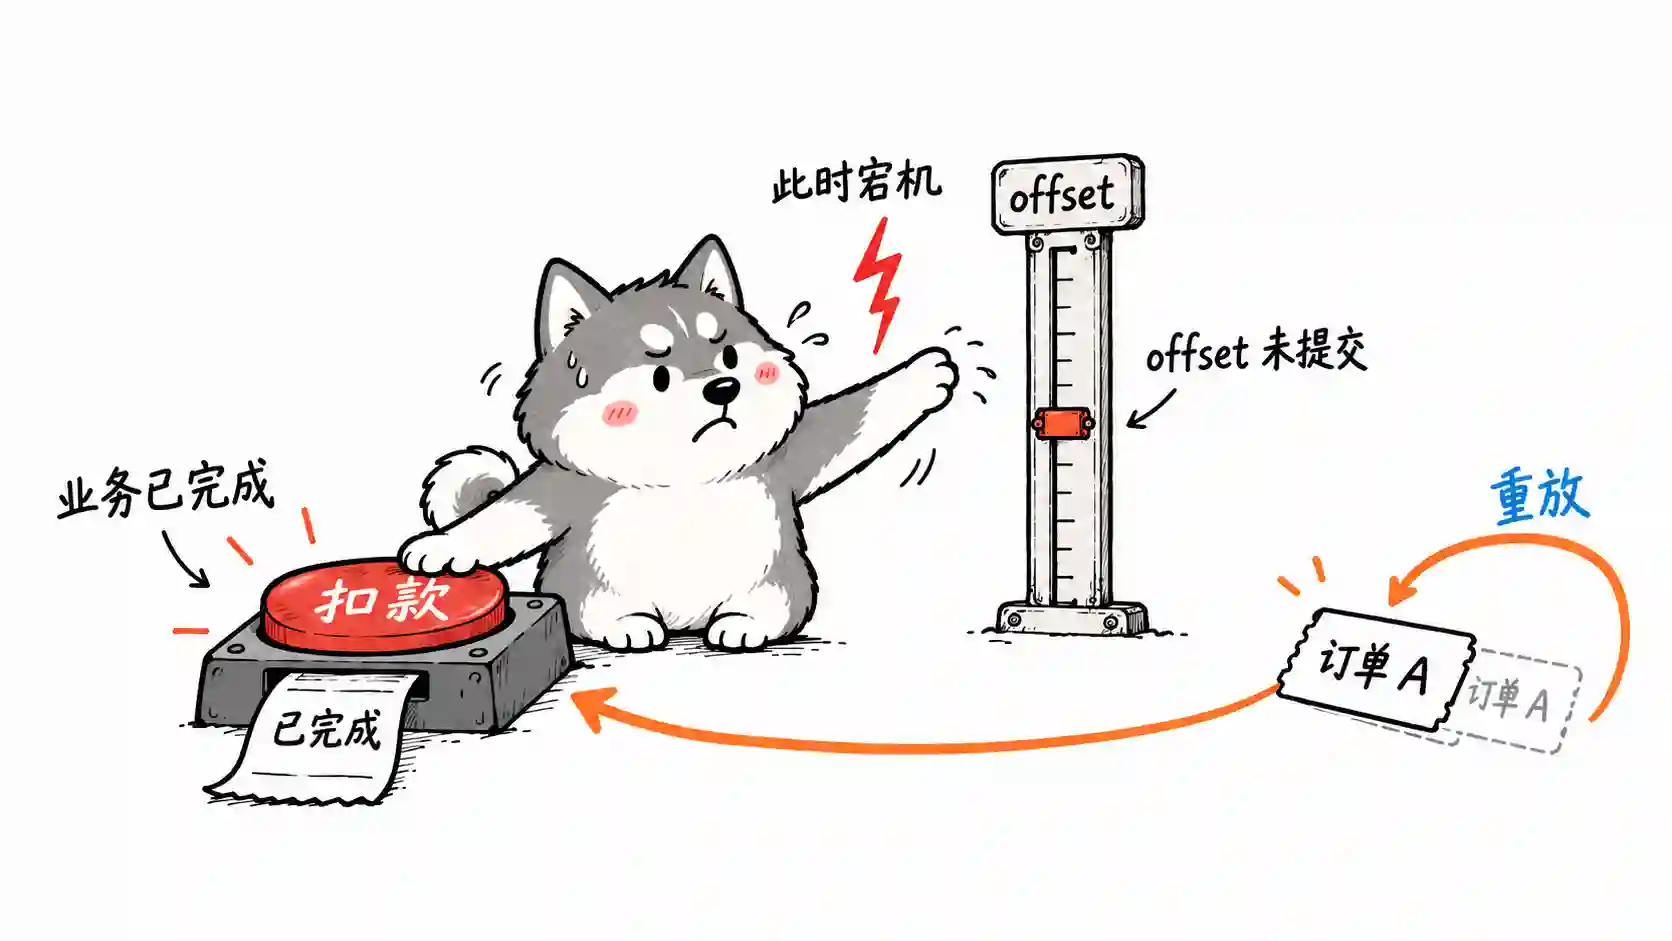
重复消费的根因一句话就能说清:消费者是“先消费、处理业务,再提交 offset”。如果业务已经处理完、offset 还没来得及提交,这时候消费者宕机或者触发 rebalance,新接手的消费者会从上次提交的 offset 重新拉取,这批消息就等于消费了两次。
所以解题思路就两条线:
| 方案 | 核心做法 | 适用场景 |
|---|---|---|
| 手动提交 + 幂等消费 | 关闭自动提交,业务成功后再手动提交 offset,配合业务层幂等(唯一索引 / 去重表 / Redis) | 绝大多数业务场景,生产环境首选 |
| Kafka 事务(EOS) | enable.idempotence=true + 事务 API,把“消费-处理-再生产”包进一个事务 |
Kafka Streams、consume-transform-produce 链路 |
深度解析
一、先搞清楚:消息到底为什么会重复
先看一遍正常的消费流程,重复的坑就藏在时序里。
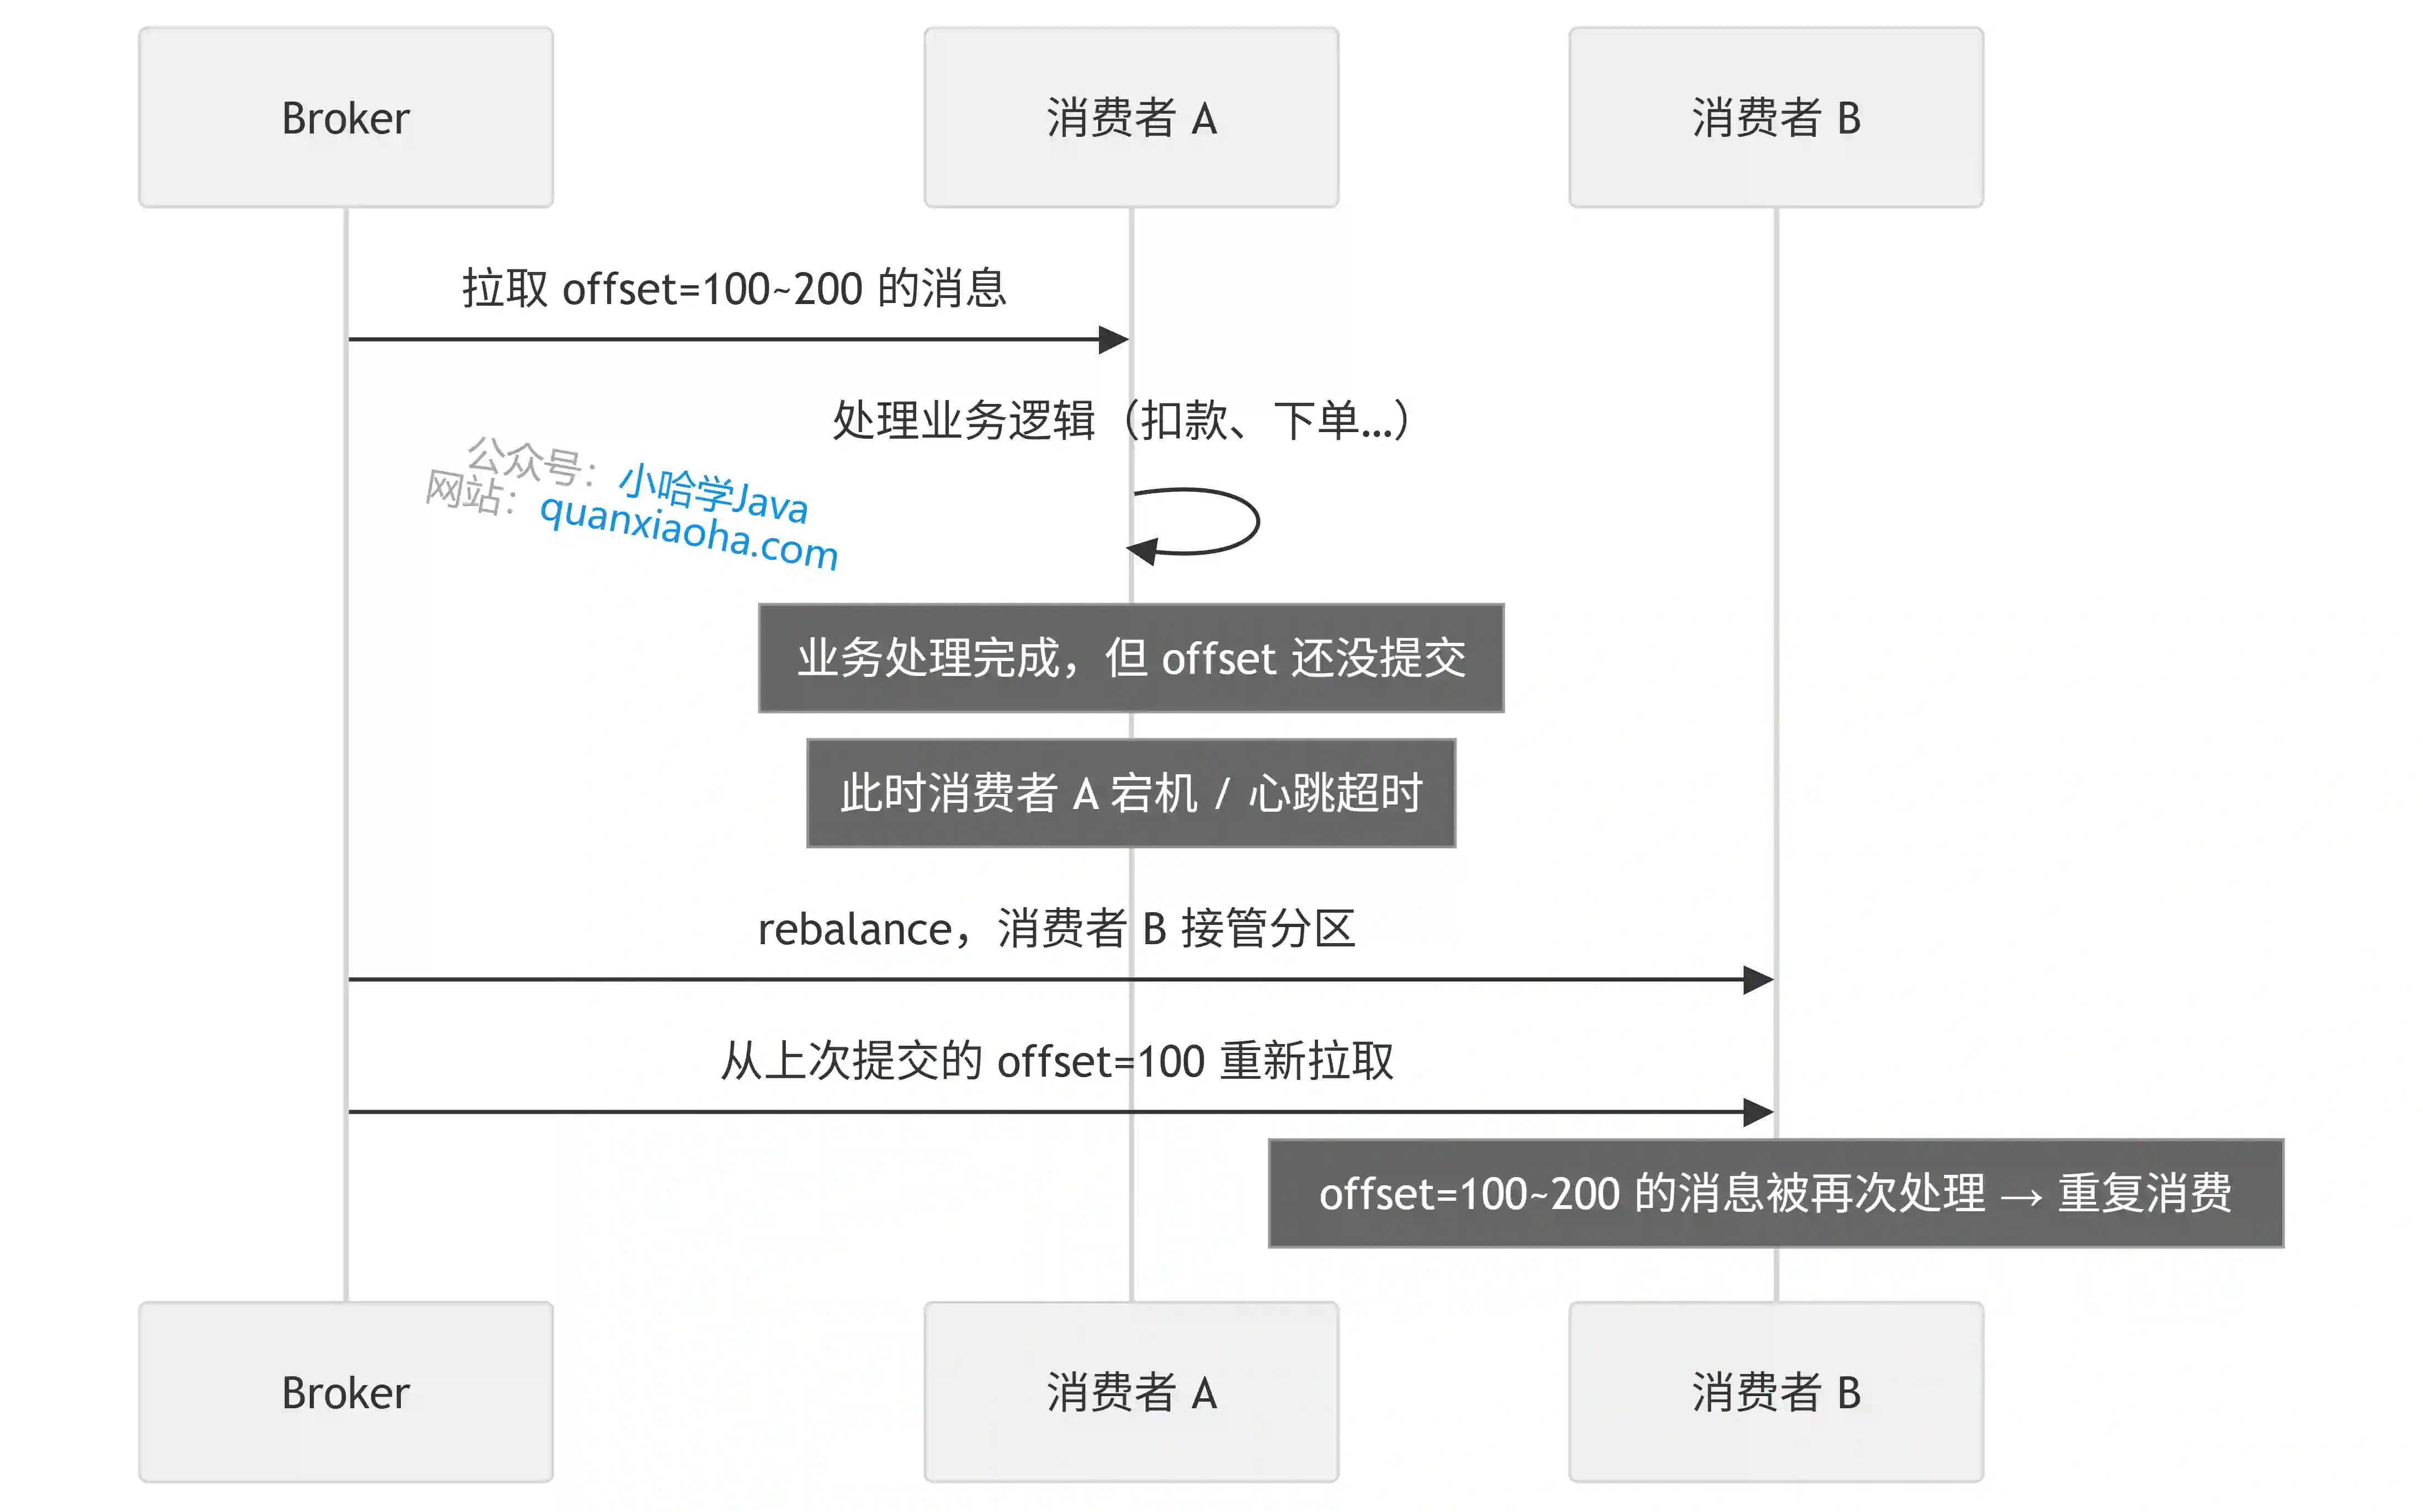
把这个时序拆开看:
- 拉取与提交分离:消费者从 Broker 拉取一批消息后,offset 的提交是另一步操作,两者之间隔着业务处理这段“真空期”
- 提交的语义是“消费到哪了”:Broker 只记录消费者组提交过的 offset,它不知道你的业务做没做完。自动提交模式下,提交动作和业务处理更是完全异步,风险更大
- rebalance 是放大器:只要消费者组里有成员进出(宕机、扩容、网络抖动导致心跳超时),就会触发 rebalance,未提交的那段 offset 必然被重新消费
还有一种容易被忽略的情况:业务处理本身耗时太长,超过了 max.poll.interval.ms(默认 5 分钟),消费者主动离组触发 rebalance,也会导致同样的重复。所以“为什么重复”的答案,本质上就一句话:业务处理和 offset 提交不是原子操作,中间任何中断都会造成回滚重放。
二、方案一:手动提交 offset + 幂等消费(生产首选)
这是最常用的组合拳,分两步走。
第一步:把提交时机握在自己手里。
props.put("enable.auto.commit", "false"); // 关闭自动提交

// 订阅时额外注册 rebalance 监听器
consumer.subscribe(Collections.singletonList("order-topic"), new ConsumerRebalanceListener() {
    @Override
    public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
        // 分区被回收前,把已处理的 offset 提交掉,减少重复窗口
        consumer.commitSync();
    }

    @Override
    public void onPartitionsAssigned(Collection<TopicPartition> partitions) {
        // 接管新分区后的初始化逻辑(按需实现)
    }
});

while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    for (ConsumerRecord<String, String> record : records) {
        processMessage(record); // 业务处理 + 幂等校验
    }
    consumer.commitSync(); // 业务全部成功后,再手动同步提交
}
几个关键点:
enable.auto.commit设为false,杜绝“业务还没处理,offset 先提交了”导致的丢消息,也避免提交时机不可控- 用
commitSync()同步提交,失败会自动重试;对吞吐有要求可以退化为commitAsync(),但退出循环前最好补一次commitSync()兜底 - 注册
ConsumerRebalanceListener,在分区被回收前提交一次,把 rebalance 带来的重复窗口压到最小
第二步:业务层做幂等,这是真正的兜底。
手动提交只是缩小了重复窗口,没办法做到绝对不重复(比如 processMessage 成功了、commitSync 之前进程被 kill -9,重启后依然会重放)。所以幂等设计才是“只消费一次”的最终防线。
| 幂等方案 | 实现方式 | 特点 |
|---|---|---|
| 数据库唯一索引 | 消息带唯一业务 ID,落表时靠唯一约束拦截重复 | 强可靠,最推荐,依赖 DB |
| 去重表 | 处理前先 insert 去重表(消息 ID 做主键),插入成功才处理 | 灵活,多一次 DB 操作 |
Redis SETNX |
以消息 ID 为 key 设值,设置过期时间 | 性能好,但要考虑 Redis 与业务操作的一致性 |
| 乐观锁 / 状态机 | update order set status='PAID' where id=? and status='UNPAID' |
天然幂等,适合状态流转类业务 |
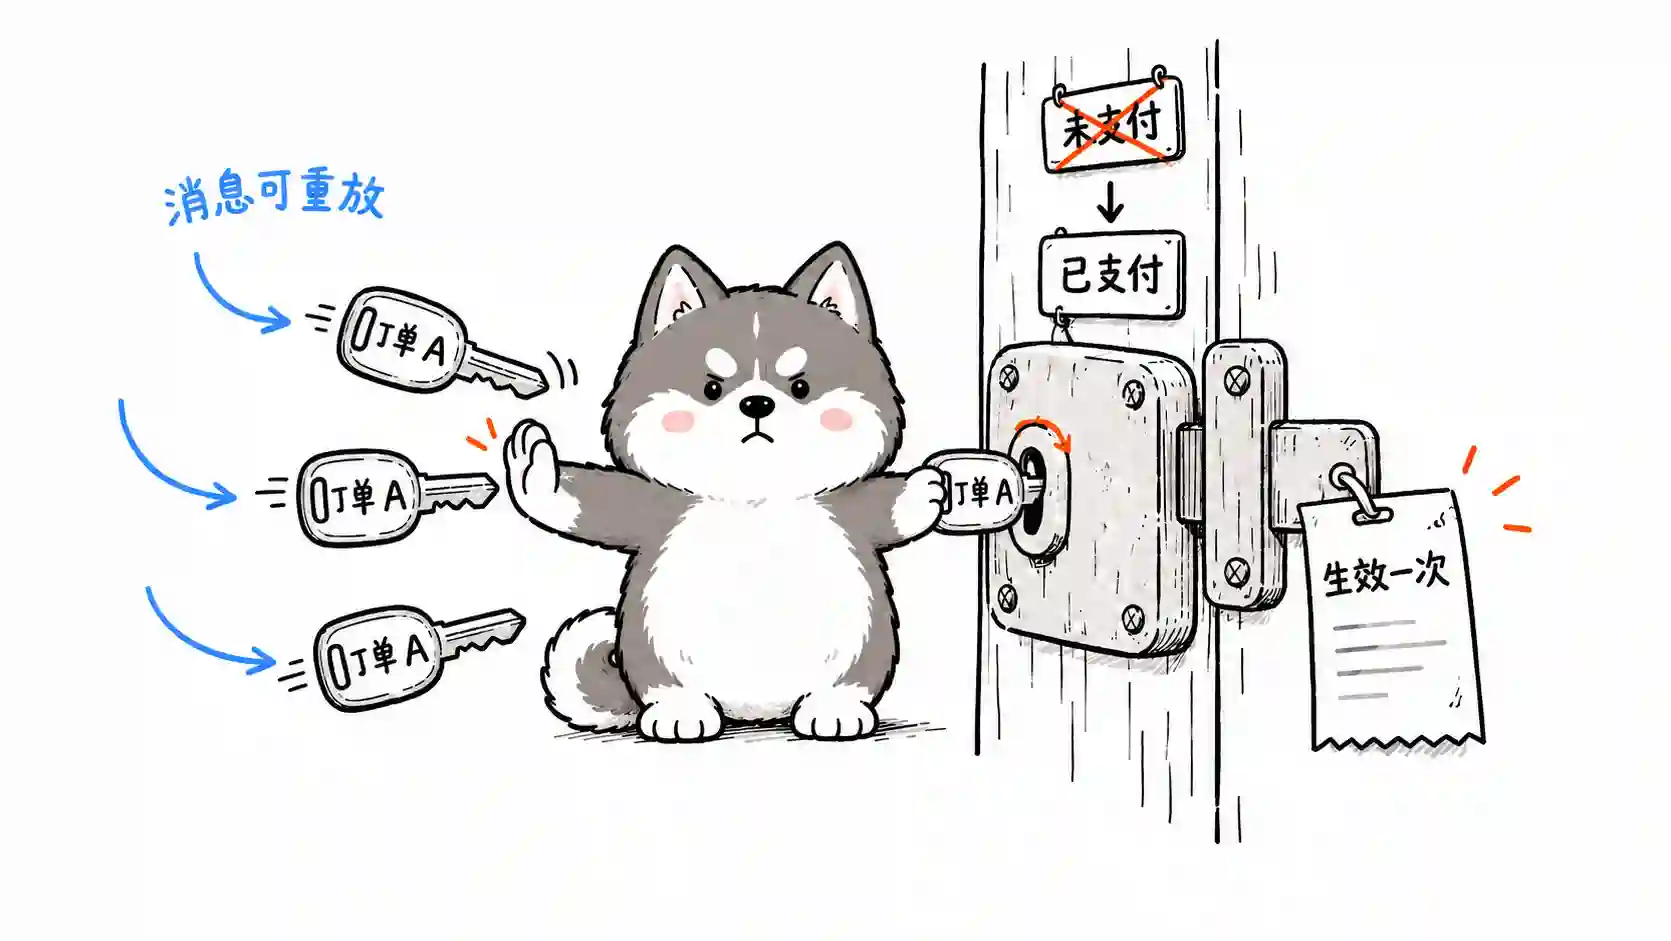
我个人在生产里最偏爱第四种。像订单这种带状态流转的业务,where status='UNPAID' 这个条件本身就把重复请求挡在外面了,连去重表都省了。唯一索引则适合落库类的场景,简单粗暴,可靠。
三、方案二:把 offset 和业务数据放进同一个数据库事务
如果下游是 MySQL,还有一个更彻底的思路:把 offset 存到业务库里,和业务数据绑在同一个本地事务里。
流程大概是这样:
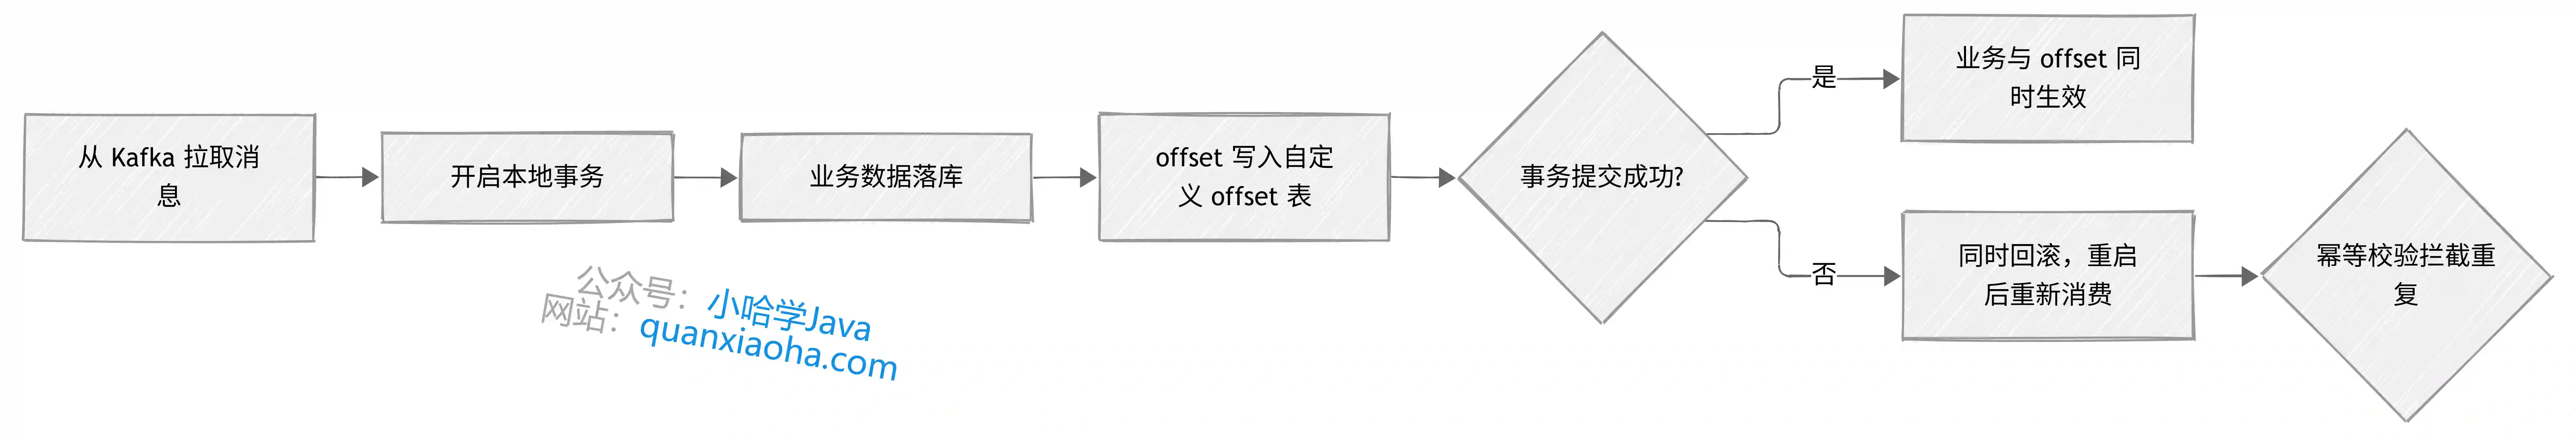
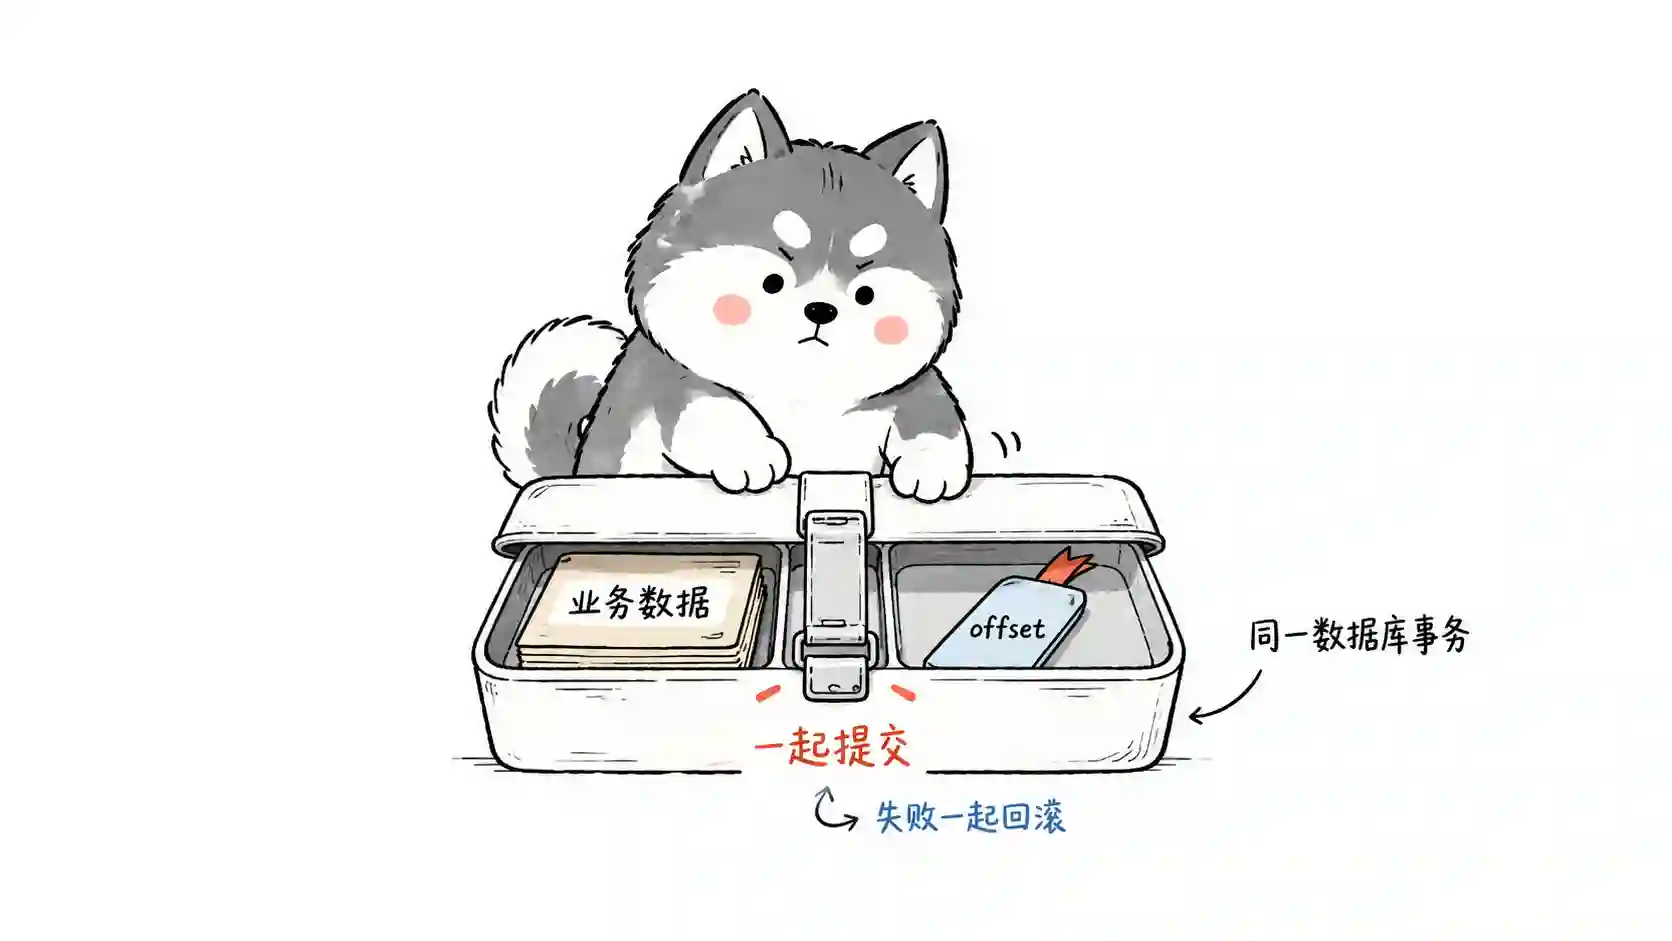
这个方案的本质,是把“消费进度”和“业务结果”变成了原子操作:
- 事务成功,业务数据和 offset 一起落库,下次从新 offset 消费,不重复
- 事务失败,两者一起回滚,重启后从旧 offset 重新拉,靠幂等设计兜住重复
- 消费前不再依赖 Broker 的提交位点,而是自己查 offset 表定位进度
代价也明显:业务处理节奏和 Kafka 消费节奏耦合在一起,吞吐会往下掉,而且只适用于下游是数据库的场景。所以它适合对一致性要求极高、吞吐压力不大的业务(比如资金、账务类)。
四、方案三:Kafka 事务与幂等生产者(0.11+)
前面两个方案都是“消费端自救”。Kafka 在 0.11 版本后自己也给出了官方解法,也就是常说的 EOS(Exactly-Once Semantics)。
分两层看:
第一层:幂等生产者,解决“生产重复”。
props.put("enable.idempotence", "true"); // Kafka 3.0+ 默认已开启
原理是 Broker 给每个生产者分配一个 PID,生产者发给每个分区的每条消息带上单调递增的 Sequence Number。Broker 端会记录 <PID, 分区, 序号>,如果收到的序号比预期小,说明是重试产生的重复消息,直接丢弃。这样就做到了单分区单会话内的生产不重不丢。
注意两个限制:只对单分区、单会话有效,生产者重启后 PID 会变,跨会话就失效了;想跨会话、跨分区,得靠事务。另外有个细节,Kafka 3.0 之后幂等虽然默认开启,但如果你显式配了 acks=1 或 retries=0 这类冲突配置,它就不会自动生效,得显式设 enable.idempotence=true。
第二层:事务,把“消费-处理-生产”打包。
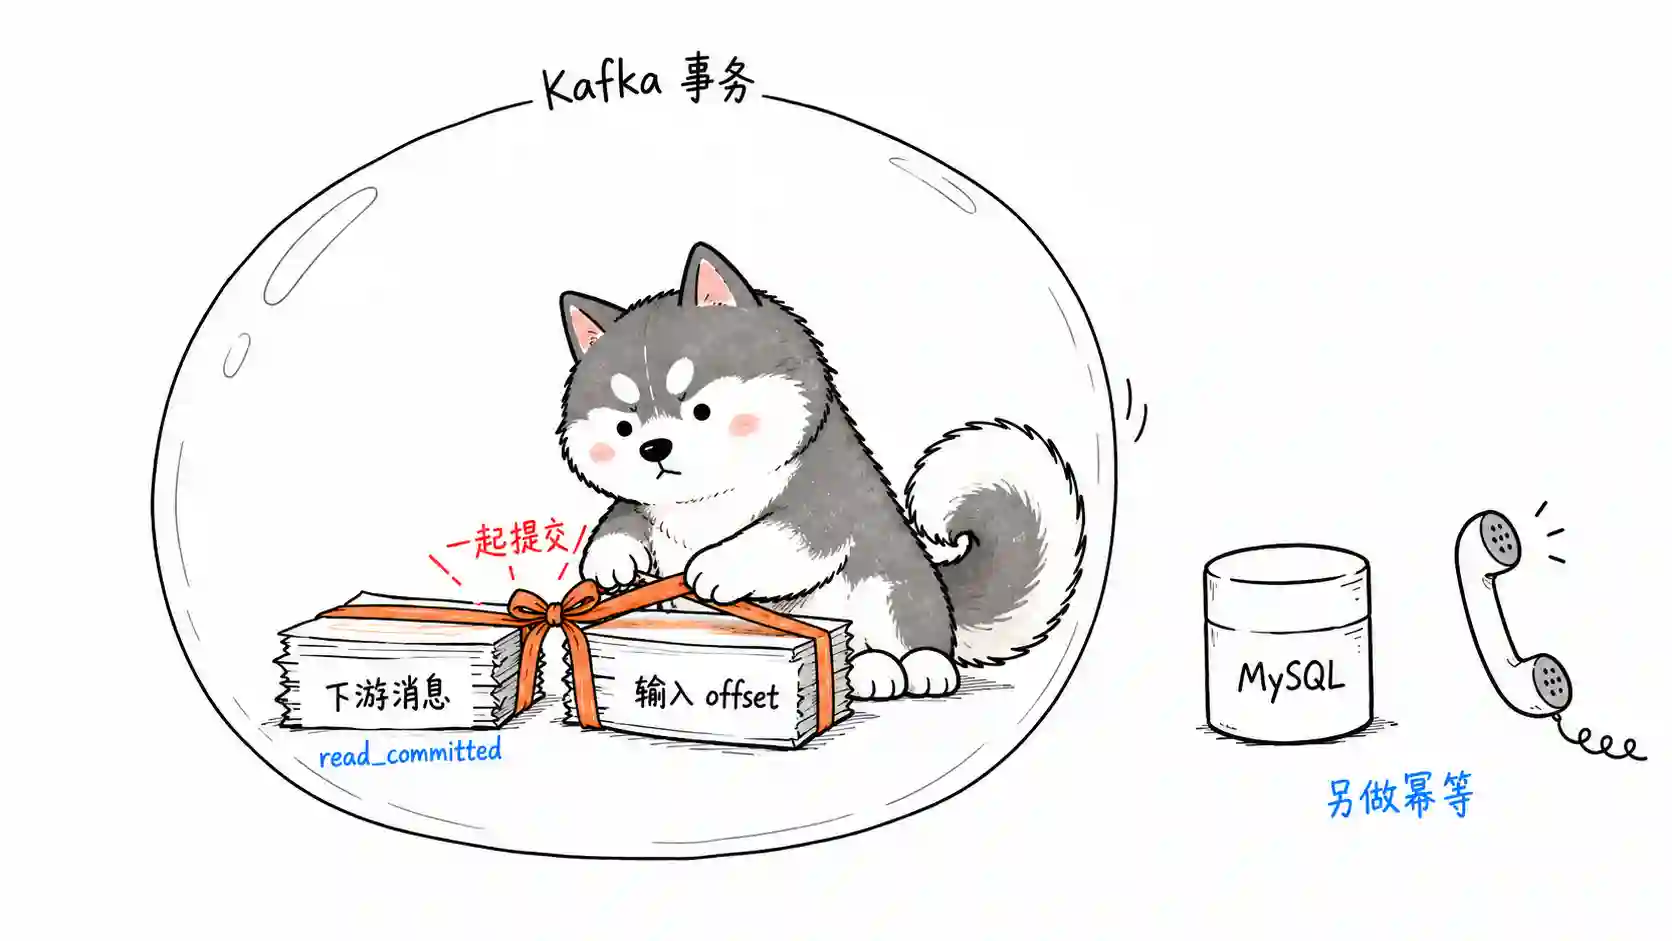
典型场景是流处理:从上游 topic 读数据、加工、写到下游 topic。事务能把“读取的 offset 提交”和“下游消息写入”绑成一个原子操作:
// 初始化事务,transactional.id 跨会话稳定,保证僵尸实例被隔离
producer.initTransactions();

while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    if (records.isEmpty()) continue;

    producer.beginTransaction();
    try {
        for (ConsumerRecord<String, String> record : records) {
            // 处理后转发到下游 topic
            producer.send(new ProducerRecord<>("sink-topic", transform(record)));
        }
        // 关键:把消费位移一并纳入事务
        producer.sendOffsetsToTransaction(
                offsets(records),
                consumer.groupMetadata());
        producer.commitTransaction(); // offset 与下游数据同生共死
    } catch (Exception e) {
        producer.abortTransaction(); // 一起回滚,下游读不到半成品
    }
}
下游消费者这边要配合设置 isolation.level=read_committed,只读已提交的事务消息,被中止的事务对下游不可见。
这里有个特别容易被追问的点,也是很多人栽跟头的地方:Kafka 事务保证的范围仅限于“Kafka 内部”的 consume-transform-produce 链路。如果你的处理逻辑是写 MySQL、调 RPC,事务管不着这些外部副作用,该重复的还是重复,最终还是得回到方案一、二的幂等设计。别指望一个配置打天下。
五、三种方案怎么选
- 一般业务(下单、通知、日志):方案一,手动提交 + 幂等设计,够用且可控
- 下游是数据库、一致性要求高:叠加方案二,offset 与业务同事务
- 纯 Kafka 内部流转(Kafka Streams、读 A topic 写 B topic):直接上方案三,框架层面就支持 EOS
面试高频追问
-
追问一:
enable.auto.commit默认值是什么?自动提交有什么风险?默认
true,间隔由auto.commit.interval.ms控制,默认 5 秒。风险在于提交由后台定时触发,和业务处理完全异步。业务还没做完 offset 就提交了,宕机后消息丢失;反过来,业务做完了、提交动作还没触发就挂了,就变成重复消费。 -
追问二:rebalance 什么时候会发生?对重复消费有什么影响?
消费者组成员数变化(宕机、扩缩容)、订阅的 topic 数变化、消费者心跳超时(
session.timeout.ms)、两次 poll 间隔超过max.poll.interval.ms(默认 5 分钟),都会触发。rebalance 后未提交的 offset 会被重新消费,是重复消费的主要推手。 -
追问三:幂等生产者为什么做不到跨会话不重复?
因为 PID 是 Broker 临时分配的,生产者重启后拿到新 PID,Broker 端的序号记录对不上号,去重就失效了。跨会话要靠
transactional.id,它持久化在配置里,重启后能通过协议 fencing 掉旧实例。 -
追问四:既然有事务,为什么大多数场景还是靠业务幂等?
Kafka 事务只覆盖 Kafka 内部的读写链路,管不到外部系统(DB、RPC、缓存)的副作用,而且事务有额外的性能开销。业务幂等是最通用、最可靠的兜底,两者通常配合使用。
常见面试变体
- 变体一:Kafka 怎么保证消息不丢失?(和本题合起来就是“不丢不重”的完整链路:生产端
acks=all+ 副本,Broker 端持久化,消费端手动提交) - 变体二:Kafka 的幂等性是怎么实现的?(PID + Sequence Number,Broker 端去重)
- 变体三:如何处理消费积压?(顺带考消费端扩容与 rebalance)
记忆口诀
重复的根子在提交,解决的落点在幂等:提交时机自己控(手动提交),重复窗口往小压(rebalance 监听器),最后一步靠幂等(唯一索引 / 状态机)。
总结
一句话:Kafka 本身只保证“至少一次”,“只消费一次”要自己动手。常规业务用“手动提交 offset + 业务幂等”这对组合拳;下游是数据库可以把 offset 和业务绑进同一个本地事务;纯 Kafka 内部流转则直接上幂等生产者 + 事务。把“业务处理与 offset 提交非原子”这个根因讲透,再给对应的幂等方案,这道题就稳了。