Redis 数据类型有哪几种?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
Redis 数据类型有哪几种?
面试考察点
-
基础掌握度:面试官想知道的不只是你能背出几个类型名,更想看你清不清楚每种类型的典型应用场景,能不能在业务设计时选对工具。
-
底层原理深度:能否说出每种类型底层数据结构(简单动态字符串、跳表、压缩列表这些),这是区分 “用过 Redis” 和 “懂 Redis” 的分水岭。
-
版本敏感度:Redis 版本迭代加了不少新类型(比如 5.0 的 Stream),知道这些说明你持续在跟进,不是吃三年前的老本。
核心答案
先说结论:Redis 常说的有 5 种基础数据类型 + 4 种特殊数据类型,一共 9 种。
5 种基础类型(必答,一个都不能少):
| 类型 | 底层数据结构 | 典型场景 |
|---|---|---|
String(字符串) |
int / embstr / raw | 缓存、计数器、分布式锁 |
Hash(哈希) |
listpack(ziplist)/ hashtable | 对象缓存、购物车 |
List(列表) |
quicklist(双向链表) | 消息队列、最新列表 |
Set(集合) |
intset / hashtable | 去重、共同好友、抽奖 |
ZSet(有序集合) |
listpack(ziplist)/ 跳表 | 排行榜、延迟队列 |
4 种特殊类型(加分项,说出来面试官眼睛会亮):
| 类型 | 引入版本 | 典型场景 |
|---|---|---|
Bitmap(位图) |
2.2(基于 String) | 签到、活跃用户统计 |
HyperLogLog(基数统计) |
2.8.9 | 海量 UV 统计 |
GEO(地理位置) |
3.2 | 附近的人、附近门店 |
Stream(流) |
5.0 | 消息队列 |
面试的时候先把 5 种基础的报出来,再补一句 “另外还有几种特殊类型”,层次感一下就出来了。
深度解析
一、5 种基础类型逐个过
1. String:最简单也最常用
String 不是 Java 里那个 String,它是二进制安全的,可以存字符串、数字,甚至序列化后的对象,最大能存 512MB。
底层有三种编码:
- int:值是整数且能用 long 表示时,直接存整数,省内存
- embstr:短字符串(不超过 44 字节),
redisObject和SDS一次分配在一块连续内存 - raw:长字符串,
redisObject和SDS分开分配
SET name "xiaoha"        # 普通缓存
SET age 18               # 整数,int 编码
INCR read_count          # 计数器,原子自增,阅读量、点赞量随便玩
SETNX lock:order 1       # 分布式锁的雏形(生产要用 Redisson)
这里提一嘴 SDS(简单动态字符串),它是 Redis 自己实现的字符串结构,比起 C 原生字符串多了记录长度、二进制安全、空间预分配这些特性,属于追问重灾区。
2. Hash:天生适合存对象
一个 Hash 就像一个小号的 HashMap,field-value 一一对应。
# 存用户对象,比 String 存 JSON 好在:改单个字段不用整个反序列化
HSET user:1001 name "xiaoha" age 18 city "hangzhou"
HGET user:1001 age        # 只取 age,不用拖家带口把整个对象拉出来
购物车也是经典场景:用户 id 做 key,商品 id 做 field,数量做 value,加购减购直接 HINCRBY,不要太顺手。
底层编码:元素少且值短时用 listpack(老版本是 ziplist),超过阈值(默认 128 个元素或单个值超过 64 字节)转 hashtable。
3. List:两端操作都快的序列
双向链表特性,头尾插删都是 O(1)。最新消息排行、朋友圈时间线、简单消息队列都靠它。
LPUSH news:latest "文章A" "文章B"   # 头部插入
LRANGE news:latest 0 9             # 拿最新 10 条
BRPOP queue:task 0                 # 阻塞式弹出,简单队列
注意 Redis 3.2 之后底层换成了 quicklist(ziplist 组成的双向链表),7.0 之后节点又换成了 listpack,纯粹为了省内存和提高性能。
4. Set:天然去重 + 集合运算
无序、不重复,最香的是支持交集、并集、差集:
SADD user:1001:follow "java" "redis"
SADD user:1002:follow "redis" "mysql"
SINTER user:1001:follow user:1002:follow   # 共同关注:redis
SPOP lottery:pool 3                        # 抽奖,随机弹 3 个
共同好友、标签推荐、抽奖,业务里到处是它。底层元素全是整数且数量不多时用 intset,否则 hashtable。
5. ZSet:带排序功能的 Set
在 Set 的基础上加了一个 score(分值),自动按 score 排序。排行榜的亲爹:
ZADD rank:game 100 "xiaoha" 95 "zhangsan" 88 "lisi"
ZREVRANGE rank:game 0 9 WITHSCORES    # top 10,分高的在前
ZINCRBY rank:game 10 "xiaoha"         # 加 10 分,实时更新排名
底层是个双结构:跳表(skiplist)负责排序范围查询,hashtable 负责按 member 快速查 score,一个类型两套索引,这设计确实优雅。
二、底层编码转换一图流
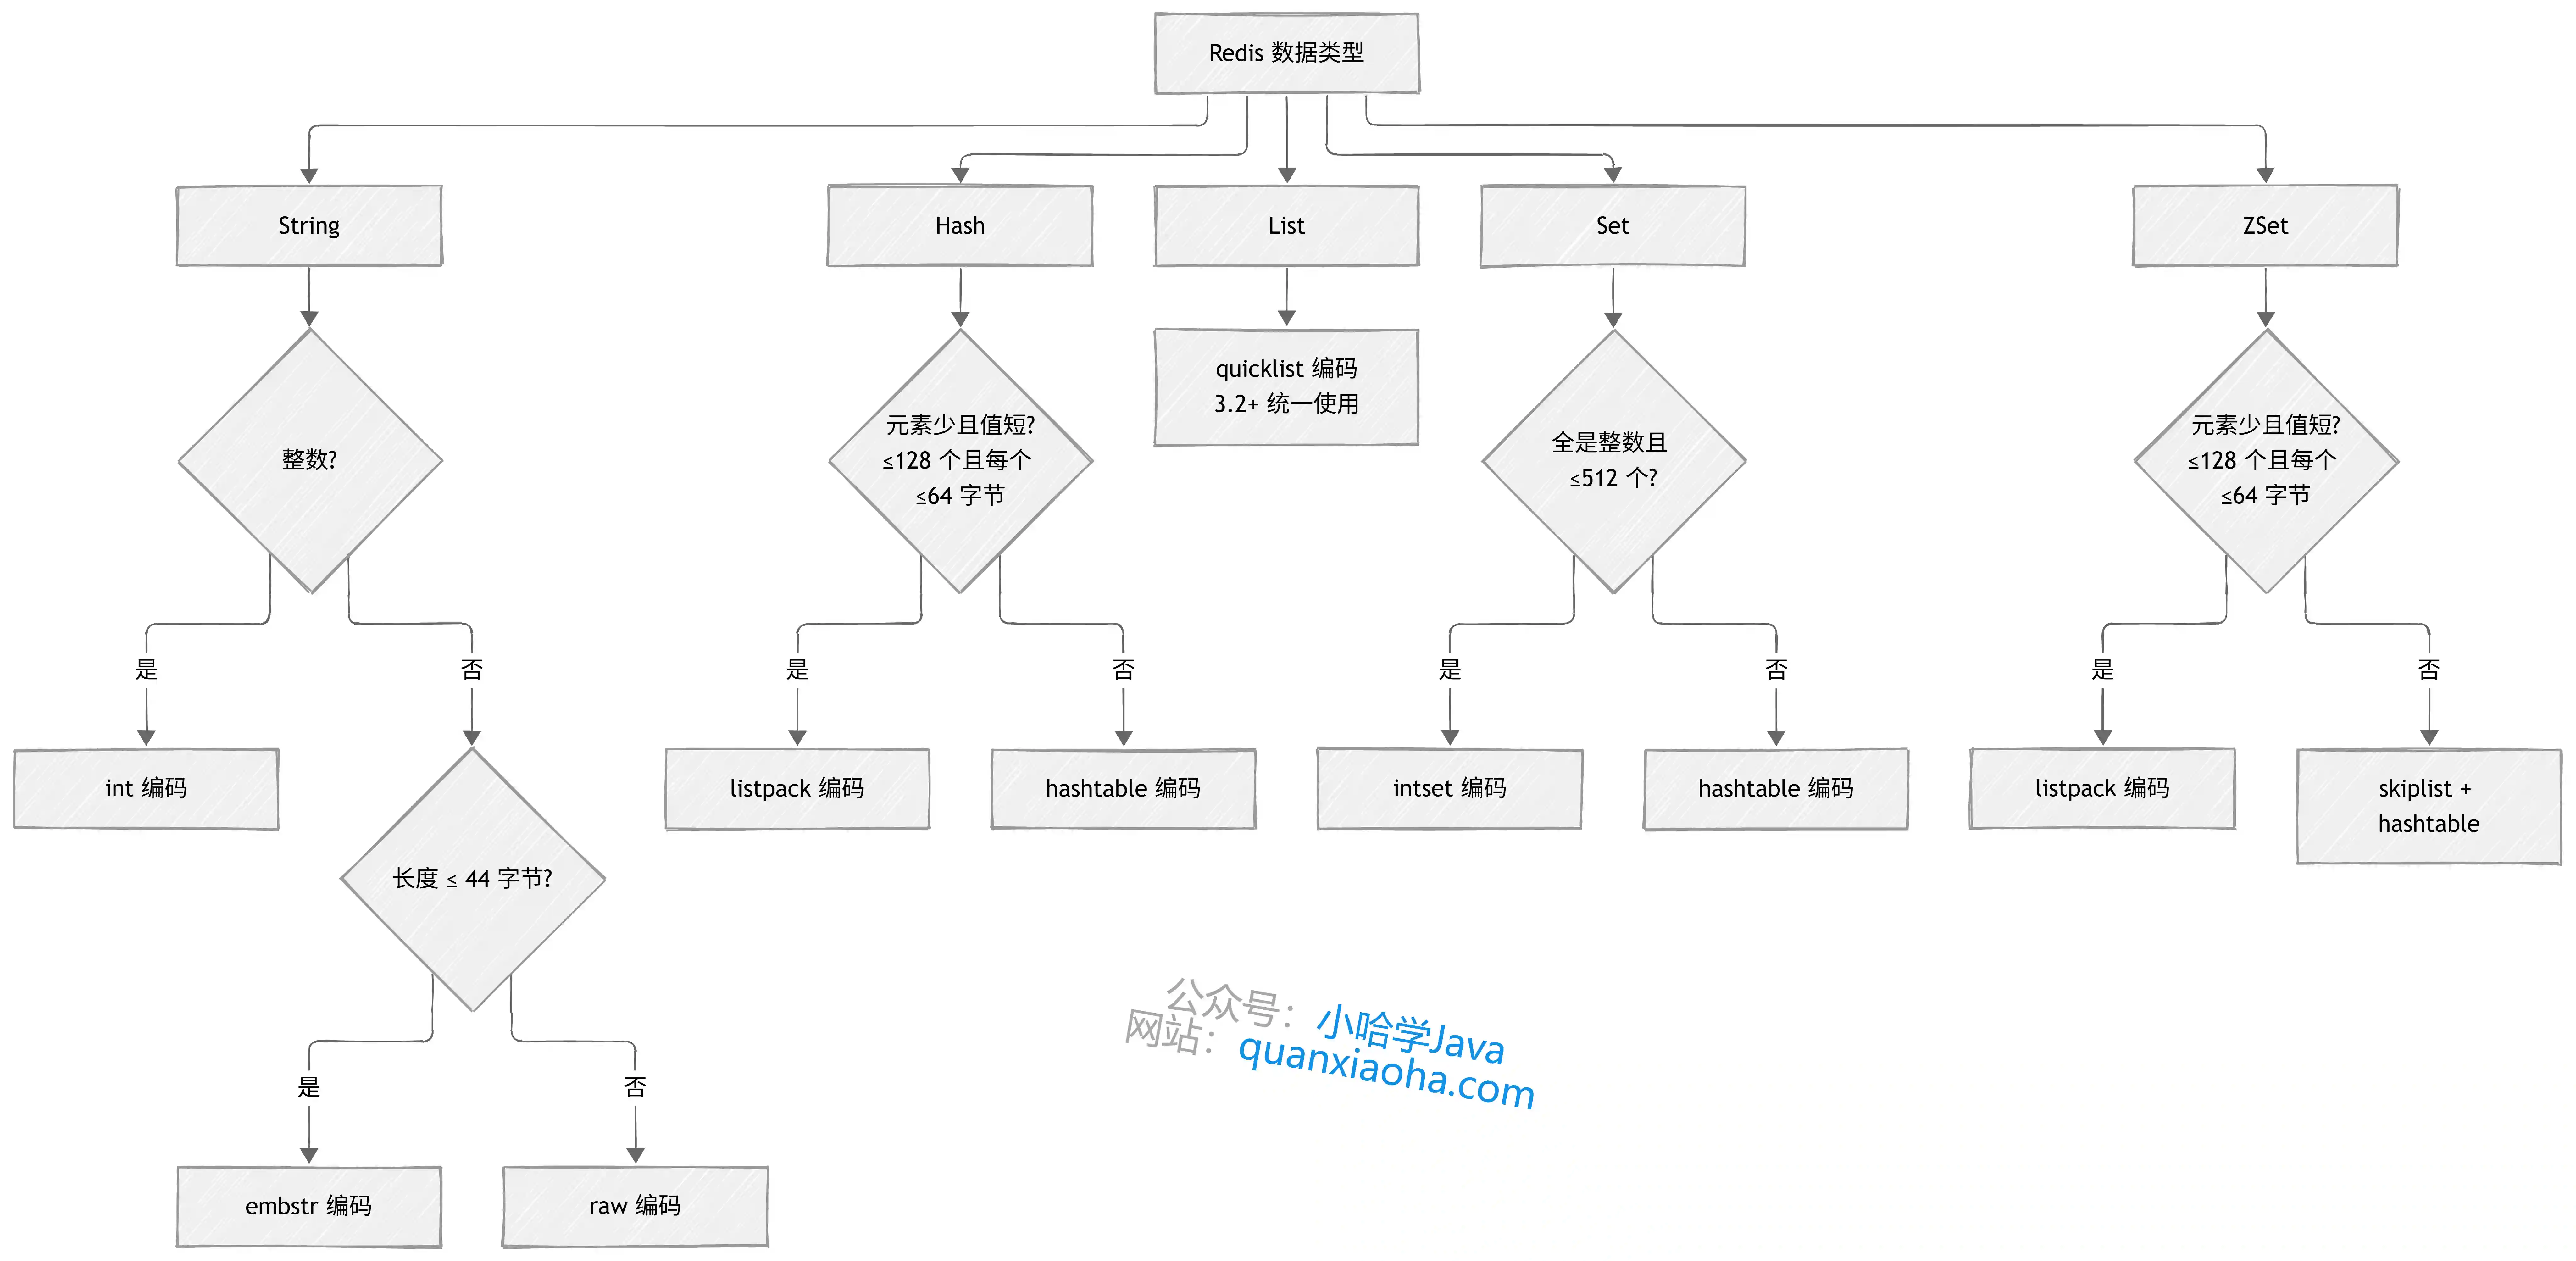
上图把 5 种基础类型和底层编码的对应关系串起来了,重点看这几个:
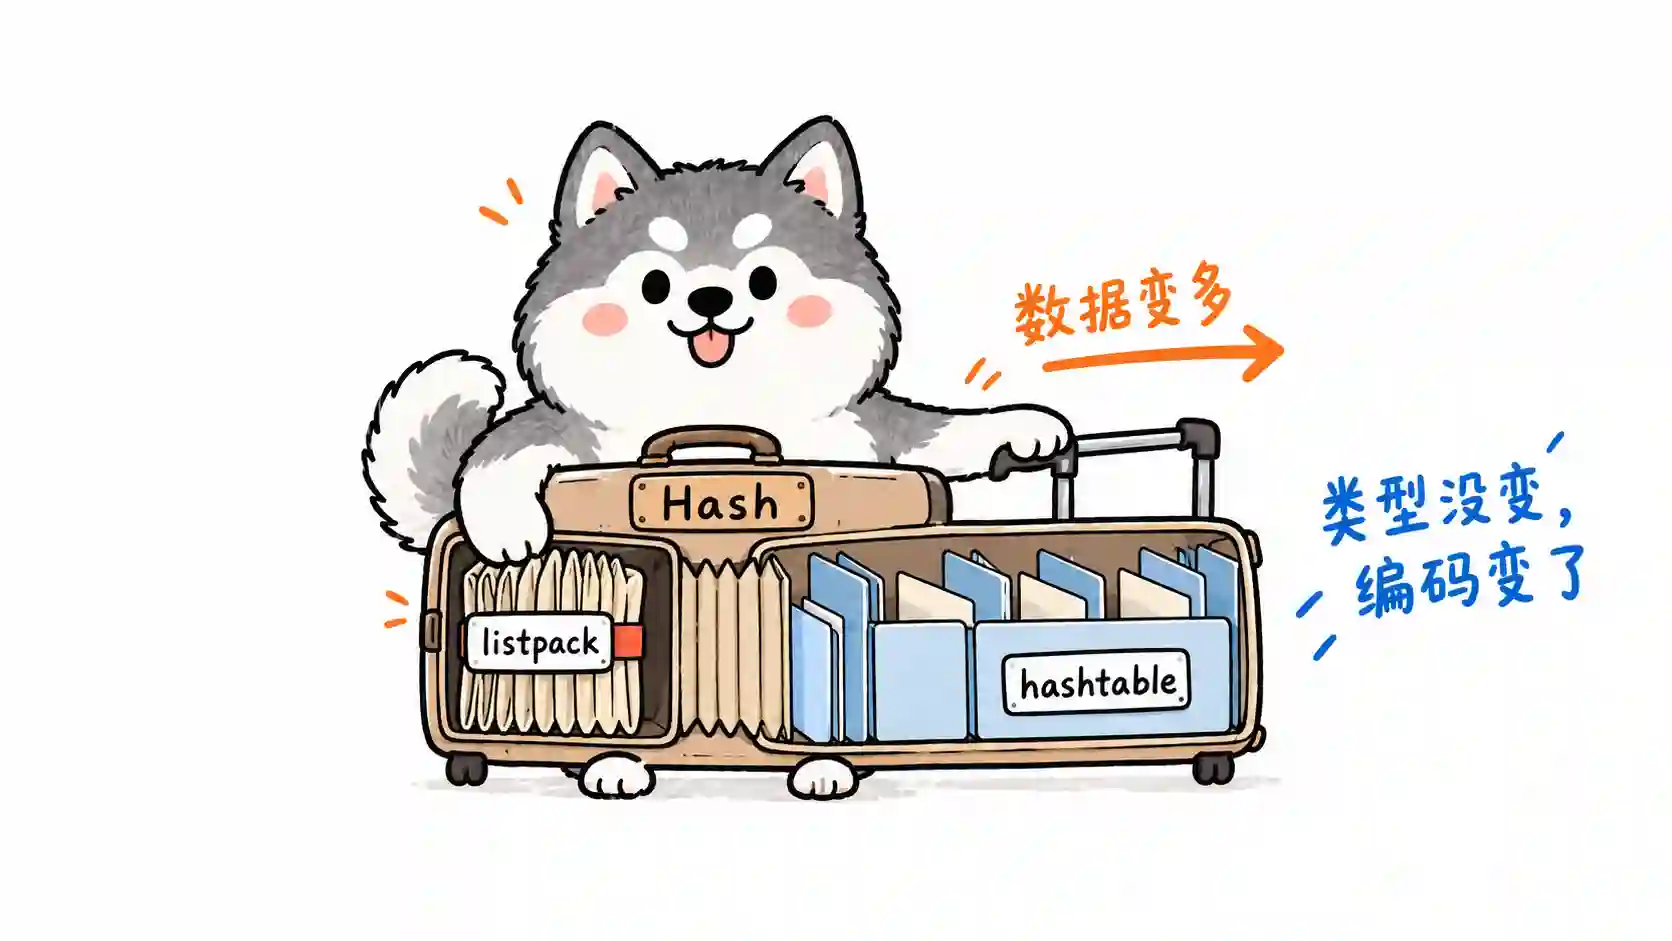
- 编码是动态切换的:数据量小用省内存的紧凑结构(listpack、intset),数据量大了自动升级成查询快的结构(hashtable、skiplist),整个过程对上层无感
- 阈值参数可调:
hash-max-listpack-entries、set-max-intset-entries这些都能在配置文件里改,不过一般没人动 - 版本差异要留心:Redis 7.0 之前 Hash/ZSet 小数据量用的是 ziplist,7.0 统一换成了 listpack(ziplist 有连锁更新的毛病,被砍了)。面试官要是追问 “为什么换”,能答到这一层就很加分
三、4 种特殊类型各显神通
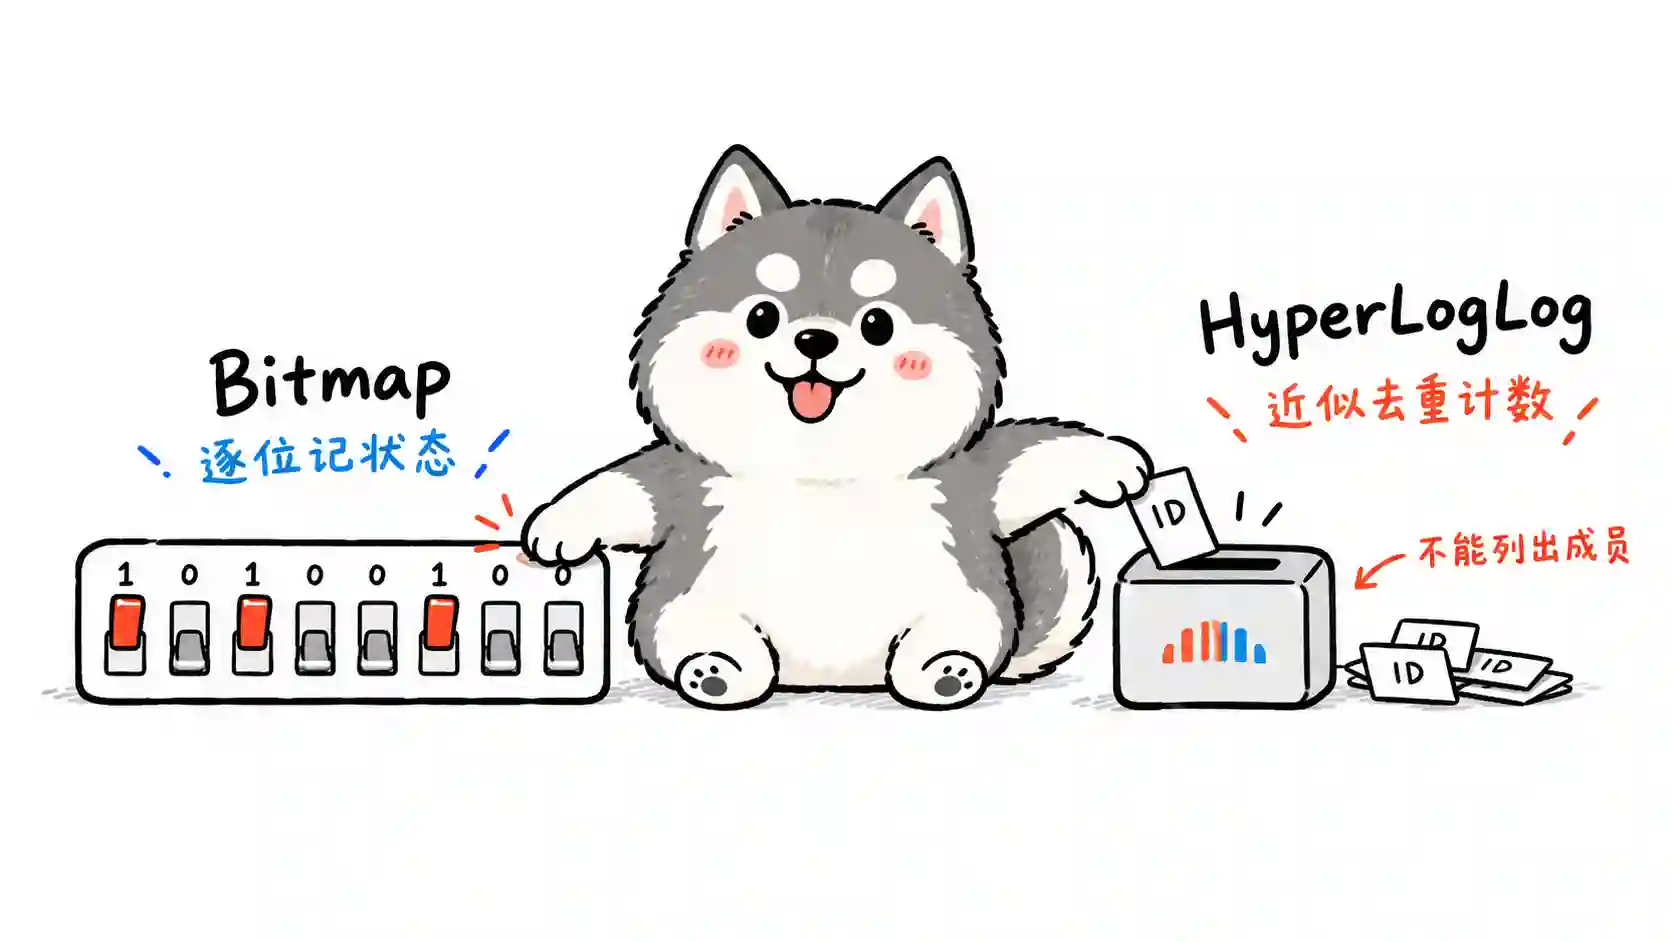
Bitmap:用比特位抠出海量统计
基于 String 实现,一个 key 就是一串二进制位,第 N 位标记第 N 个用户的状态:
SETBIT sign:202610 1001 1     # 用户 1001 签到(10 月)
GETBIT sign:202610 1001       # 查他签没签
BITCOUNT sign:202610          # 这个月总签到人次
1 亿用户一天的签到状态,用 Bitmap 只要 12MB 左右,用 String 存用户 id 得吃掉多少倍内存,自己算算就知道了。签到、日活、布隆过滤器底层都是它。
HyperLogLog:0.81% 误差换 12KB 固定内存
专门做基数统计(去重计数)。比如统计一个亿 UV,它固定只花 12KB 内存,代价是有 0.81% 左右的误差:
PFADD page:uv:1001 "user1" "user2" "user3"
PFCOUNT page:uv:1001      # 返回去重后的访问数(近似值)
统计 PV 要精确数字用计数器,统计 UV 这种上亿的量、又不在乎差那几百几千的,HyperLogLog 就是为你准备的。
GEO:附近的人背后的功臣
底层就是 ZSet,用 GeoHash 把经纬度编码成分值存进去,范围查询直接复用 ZSet 的能力:
GEOADD stores 120.15 30.28 "store:001"     # 添加门店经纬度
GEOSEARCH stores FROMLONLAT 120.16 30.28 BYRADIUS 3 km ASC   # 3 公里内的店,按距离排
附近的人、附近的酒店、附近的充电桩,全是这套。
Stream:5.0 才补上的消息队列
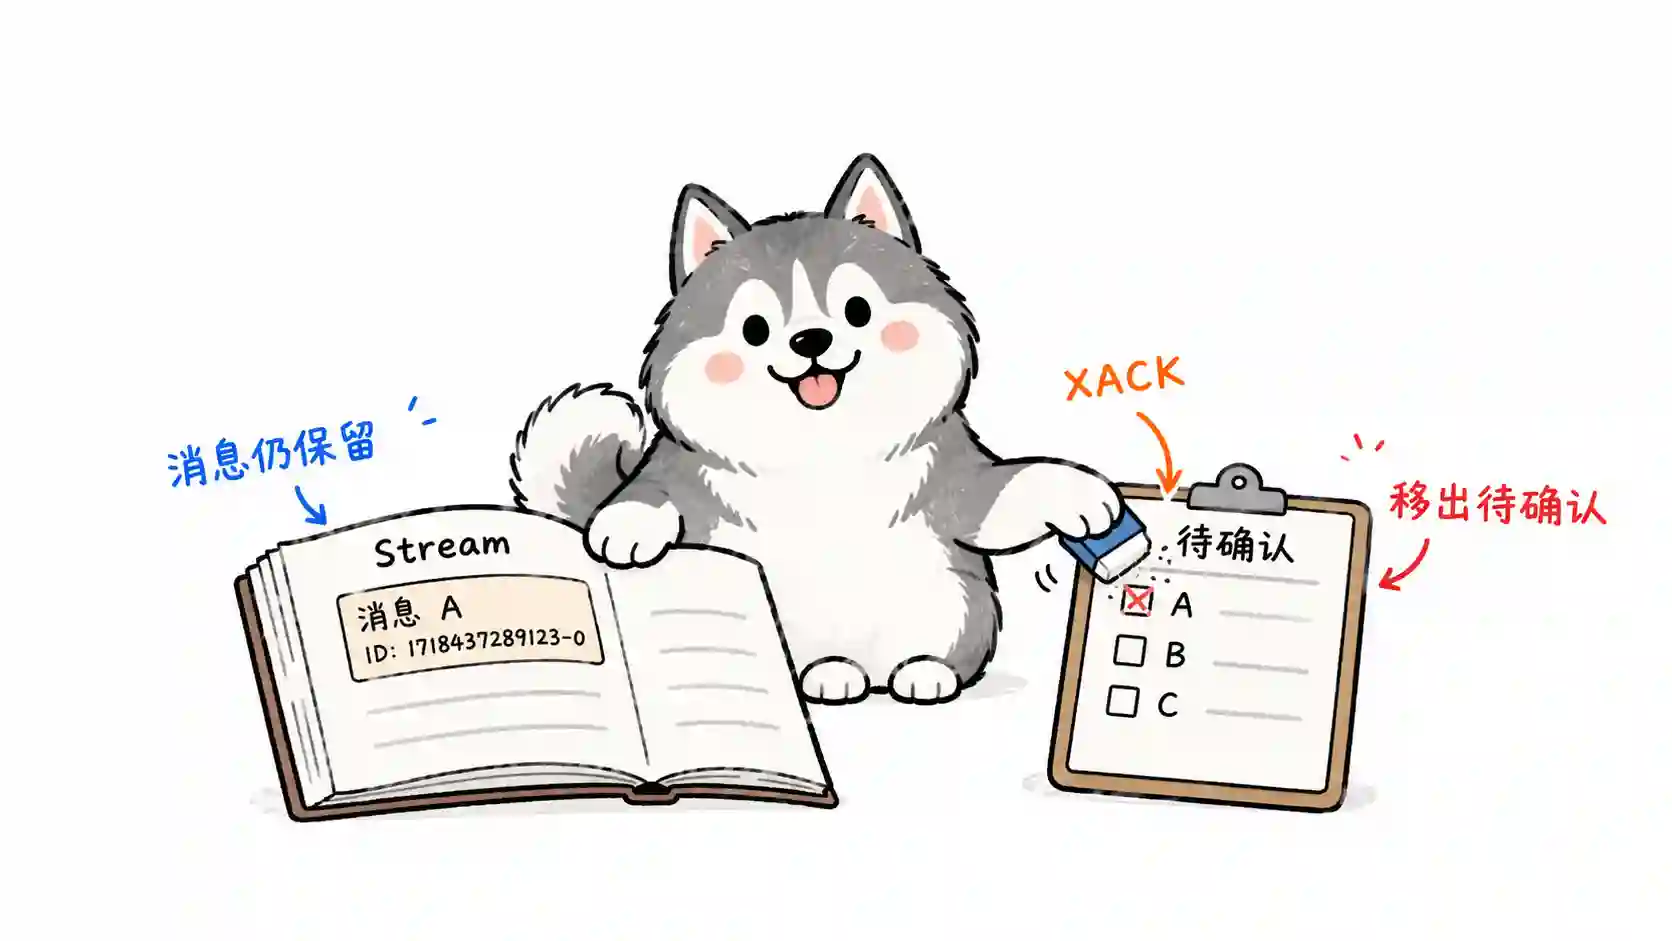
List 做消息队列有两个硬伤:没有消费确认、不支持消费组。Stream 就是为补这个坑而生的:
XADD mq:orders * orderId 1001 amount 99    # 生产消息,* 自动生成 id
XGROUP CREATE mq:orders g1 0               # 创建消费组
XREADGROUP GROUP g1 c1 COUNT 10 STREAMS mq:orders >   # 消费
XACK mq:orders g1 1727000000000-0          # 确认,消息才真正出队
持久化、消费组、消息确认都有了。不过说实话,生产环境真要上消息队列,Kafka、RocketMQ 还是主流,Stream 更适合中小体量又不想引入额外组件的场景。
面试高频追问
-
追问一:String 的底层 SDS 相比 C 字符串好在哪?
记录了长度,拿长度 O(1);二进制安全,能存图片序列化字节;空间预分配 + 惰性释放,减少内存重分配。
-
追问二:ZSet 为什么用跳表不用红黑树?
跳表实现简单、范围查询更顺手(链表顺序遍历即可)、按 rank 查找高效,而且改并发锁的粒度设计也更友好。作者 antirez 自己在邮件里聊过这个取舍。
-
追问三:怎么用 Redis 实现一个排行榜?
ZSet:
ZADD写分、ZINCRBY加分、ZREVRANGE取 top N、ZREVRANK查自己的名次。同分排序可以用 “分数拼接时间戳” 这类技巧。 -
追问四:海量数据下统计 UV 怎么做?
精确去重用 Set(内存炸)或者分片 + 归并;允许近似就用 HyperLogLog,12KB 固定内存搞定,误差 0.81%。
常见面试变体
- “Redis 的 Hash 类型什么场景下用 hashtable 编码?”
- “List 和 Stream 做消息队列的区别?”
- “Bitmap 和 Set 做签到系统,你选哪个?为什么?”
- “ZSet 的跳表是怎么回事?”(这个几乎必追问,建议单独准备)
记忆口诀
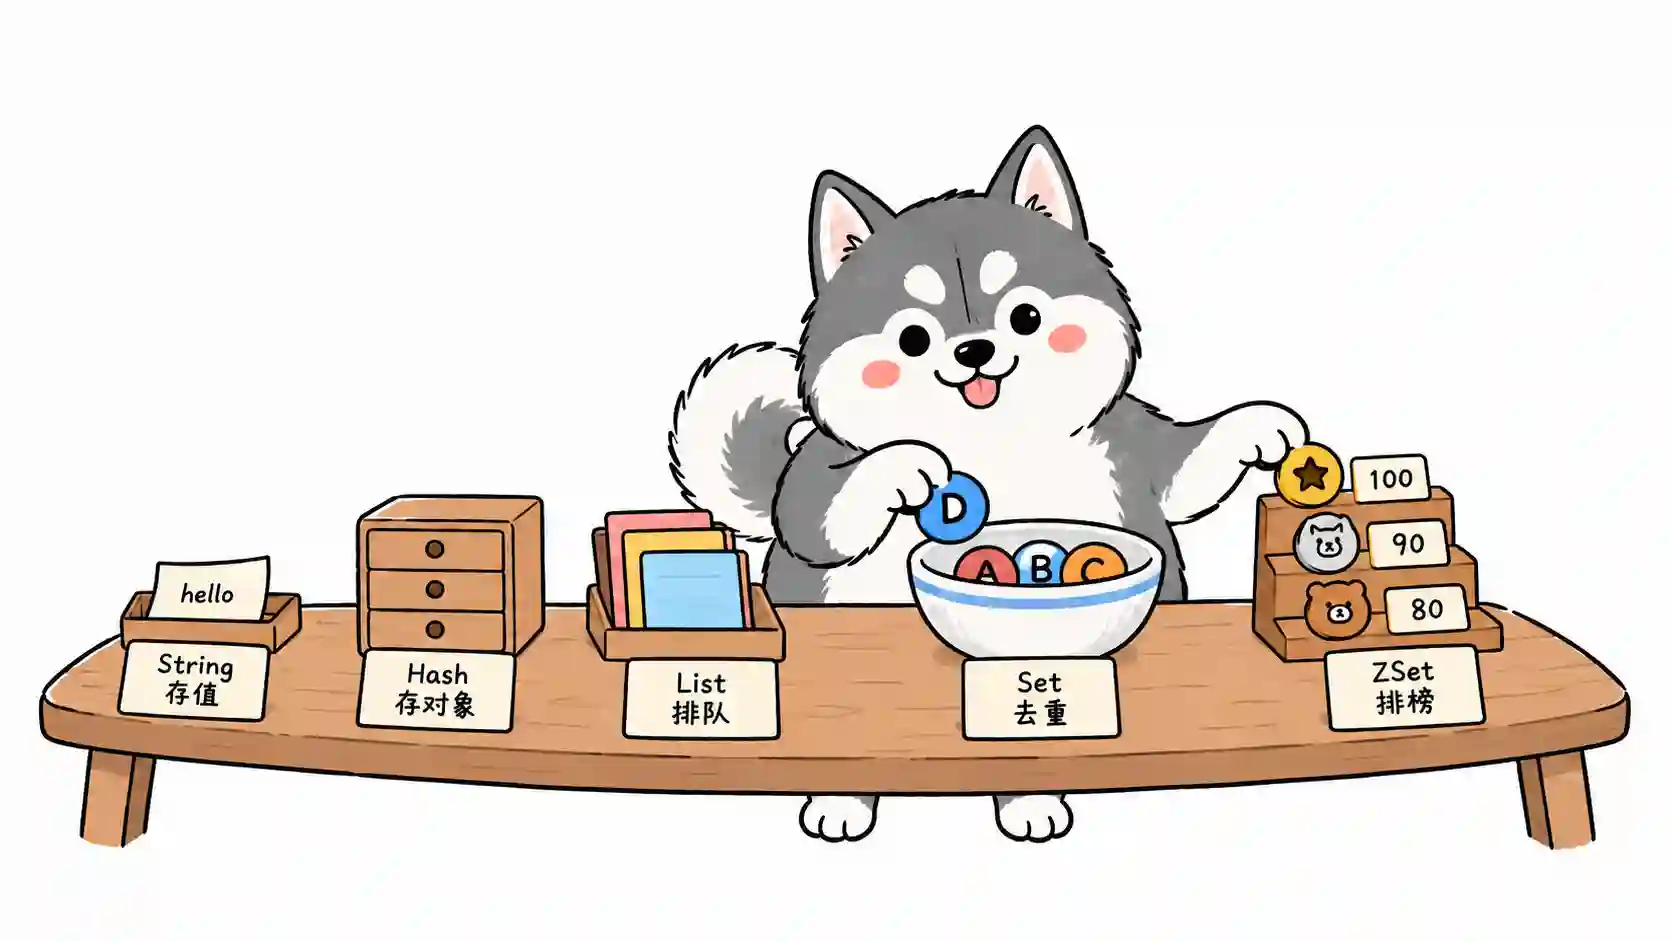
基础五兄弟:串(String)哈(Hash)列(List)集(Set)排(ZSet)。字符串存值、哈希存对象、列表排队、集合去重、有序集合排榜。
特殊四件套:位图签到、Hyper 计数、GEO 找人、Stream 收消息。
总结
一句话:5 种基础类型是保命的,底层编码和应用场景是加分的,4 种特殊类型是让面试官点头的。回答的时候按 “类型 → 场景 → 底层结构” 的顺序讲,从 String 一路串到 Stream,这道开胃菜就能吃出硬菜的分量。