Redis 和 Memcached 的区别是什么?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
基础掌握度:面试官想听的不只是几个区别点,更要看你有没有理解两者在数据结构、线程模型、内存管理这些底层设计上的差异。
-
选型能力:考察你在实际项目中能不能根据业务场景(要不要持久化、要不要丰富数据结构、数据量多大)做出合理选型,而不是无脑上 Redis。
-
原理深度:Redis 的单线程模型为什么快?Memcached 的多线程加锁是怎么回事?这些追问一出来,就知道你是真用过还是背答案。
核心答案
先说结论:Redis 功能更全、生态更强,是当下主流选择;Memcached 胜在简单纯粹,多线程处理海量小请求时依然有一席之地。 两者的核心区别我整理成一张表:
| 对比维度 | Redis | Memcached |
|---|---|---|
| 数据结构 | String、Hash、List、Set、ZSet、Bitmap、HyperLogLog、Stream 等 | 只支持简单字符串(需自行序列化) |
| 持久化 | 支持 RDB 快照 + AOF 日志 | 不支持,纯内存,重启数据全丢 |
| 高可用 | 主从复制、哨兵自动故障转移、Cluster 集群 | 原生不支持,依赖客户端一致性哈希 |
| 线程模型 | 核心命令单线程(6.0 后网络 IO 多线程) | 多线程 + 锁 |
| 内存管理 | jemalloc 分配器 + 8 种淘汰策略 | Slab Allocation 分配机制 |
| 事务支持 | MULTI/EXEC 事务 + Lua 脚本 | 仅 cas 轻量原子操作 |
| 单值大小 | String 类型上限 512MB | 默认单个 value 1MB |
| 过期机制 | 惰性删除 + 定期删除 | 惰性删除 |
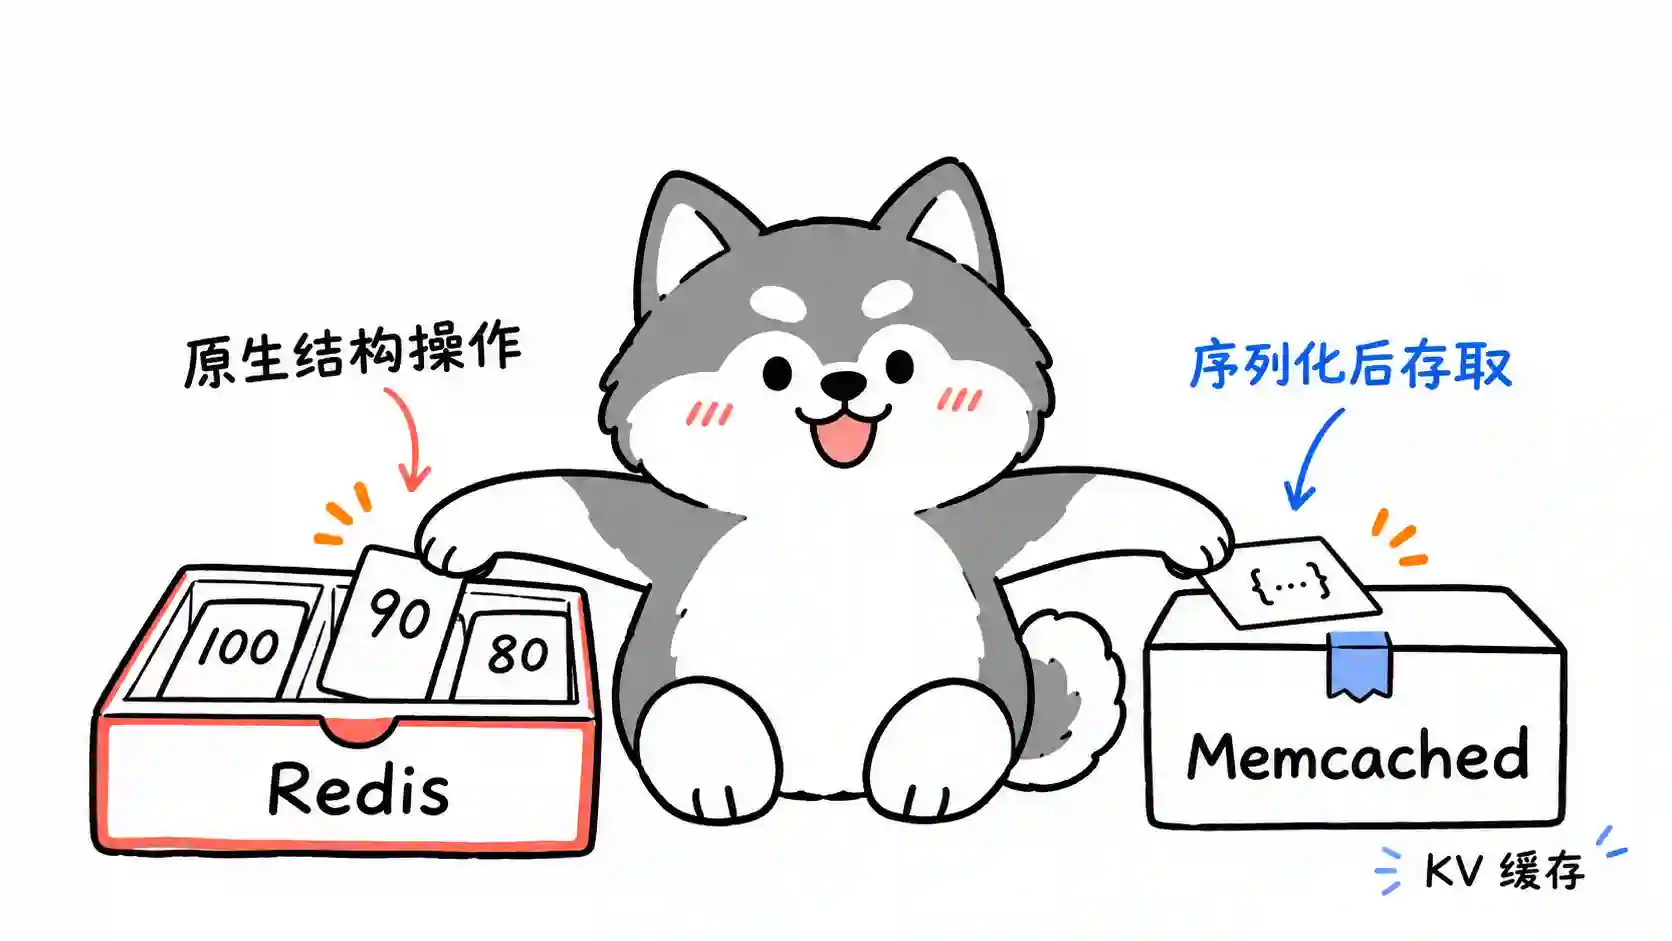
一句话概括:Redis 是“数据结构服务器”,Memcached 是“纯粹的 KV 缓存”。这个定位差异决定了后面所有的区别。
深度解析
一、数据结构:最本质的差异
Memcached 只认字符串,value 存进去是什么就是什么,想存个对象?自己先序列化成字节数组。Redis 不一样,它原生支持丰富的数据结构,而且每种结构都对应一批原子命令。
这个差异直接决定了你能做什么:
- 用 Hash 存用户对象,单字段读写,不用整个序列化反序列化
- 用 ZSet 做排行榜,
ZINCRBY一条命令搞定分数更新和排序 - 用 Set 做共同好友(
SINTER)、标签去重 - 用 Bitmap 做签到、活跃用户统计,一个亿级用户量才占十几 MB
- 用 Pub/Sub 或 Stream 做简易消息队列
这些能力 Memcached 统统没有。当年我做社区项目,排行榜需求一出来,用 Memcached 的话得把全量数据拉到应用层排序再塞回去,又慢又别扭;Redis 一个 ZREVRANGE 就完事,这就是数据结构带来的降维打击。
二、线程模型:单线程为什么反而快
很多人第一反应是“Redis 单线程,Memcached 多线程,那 Memcached 不是更快?” 这是个经典误区。
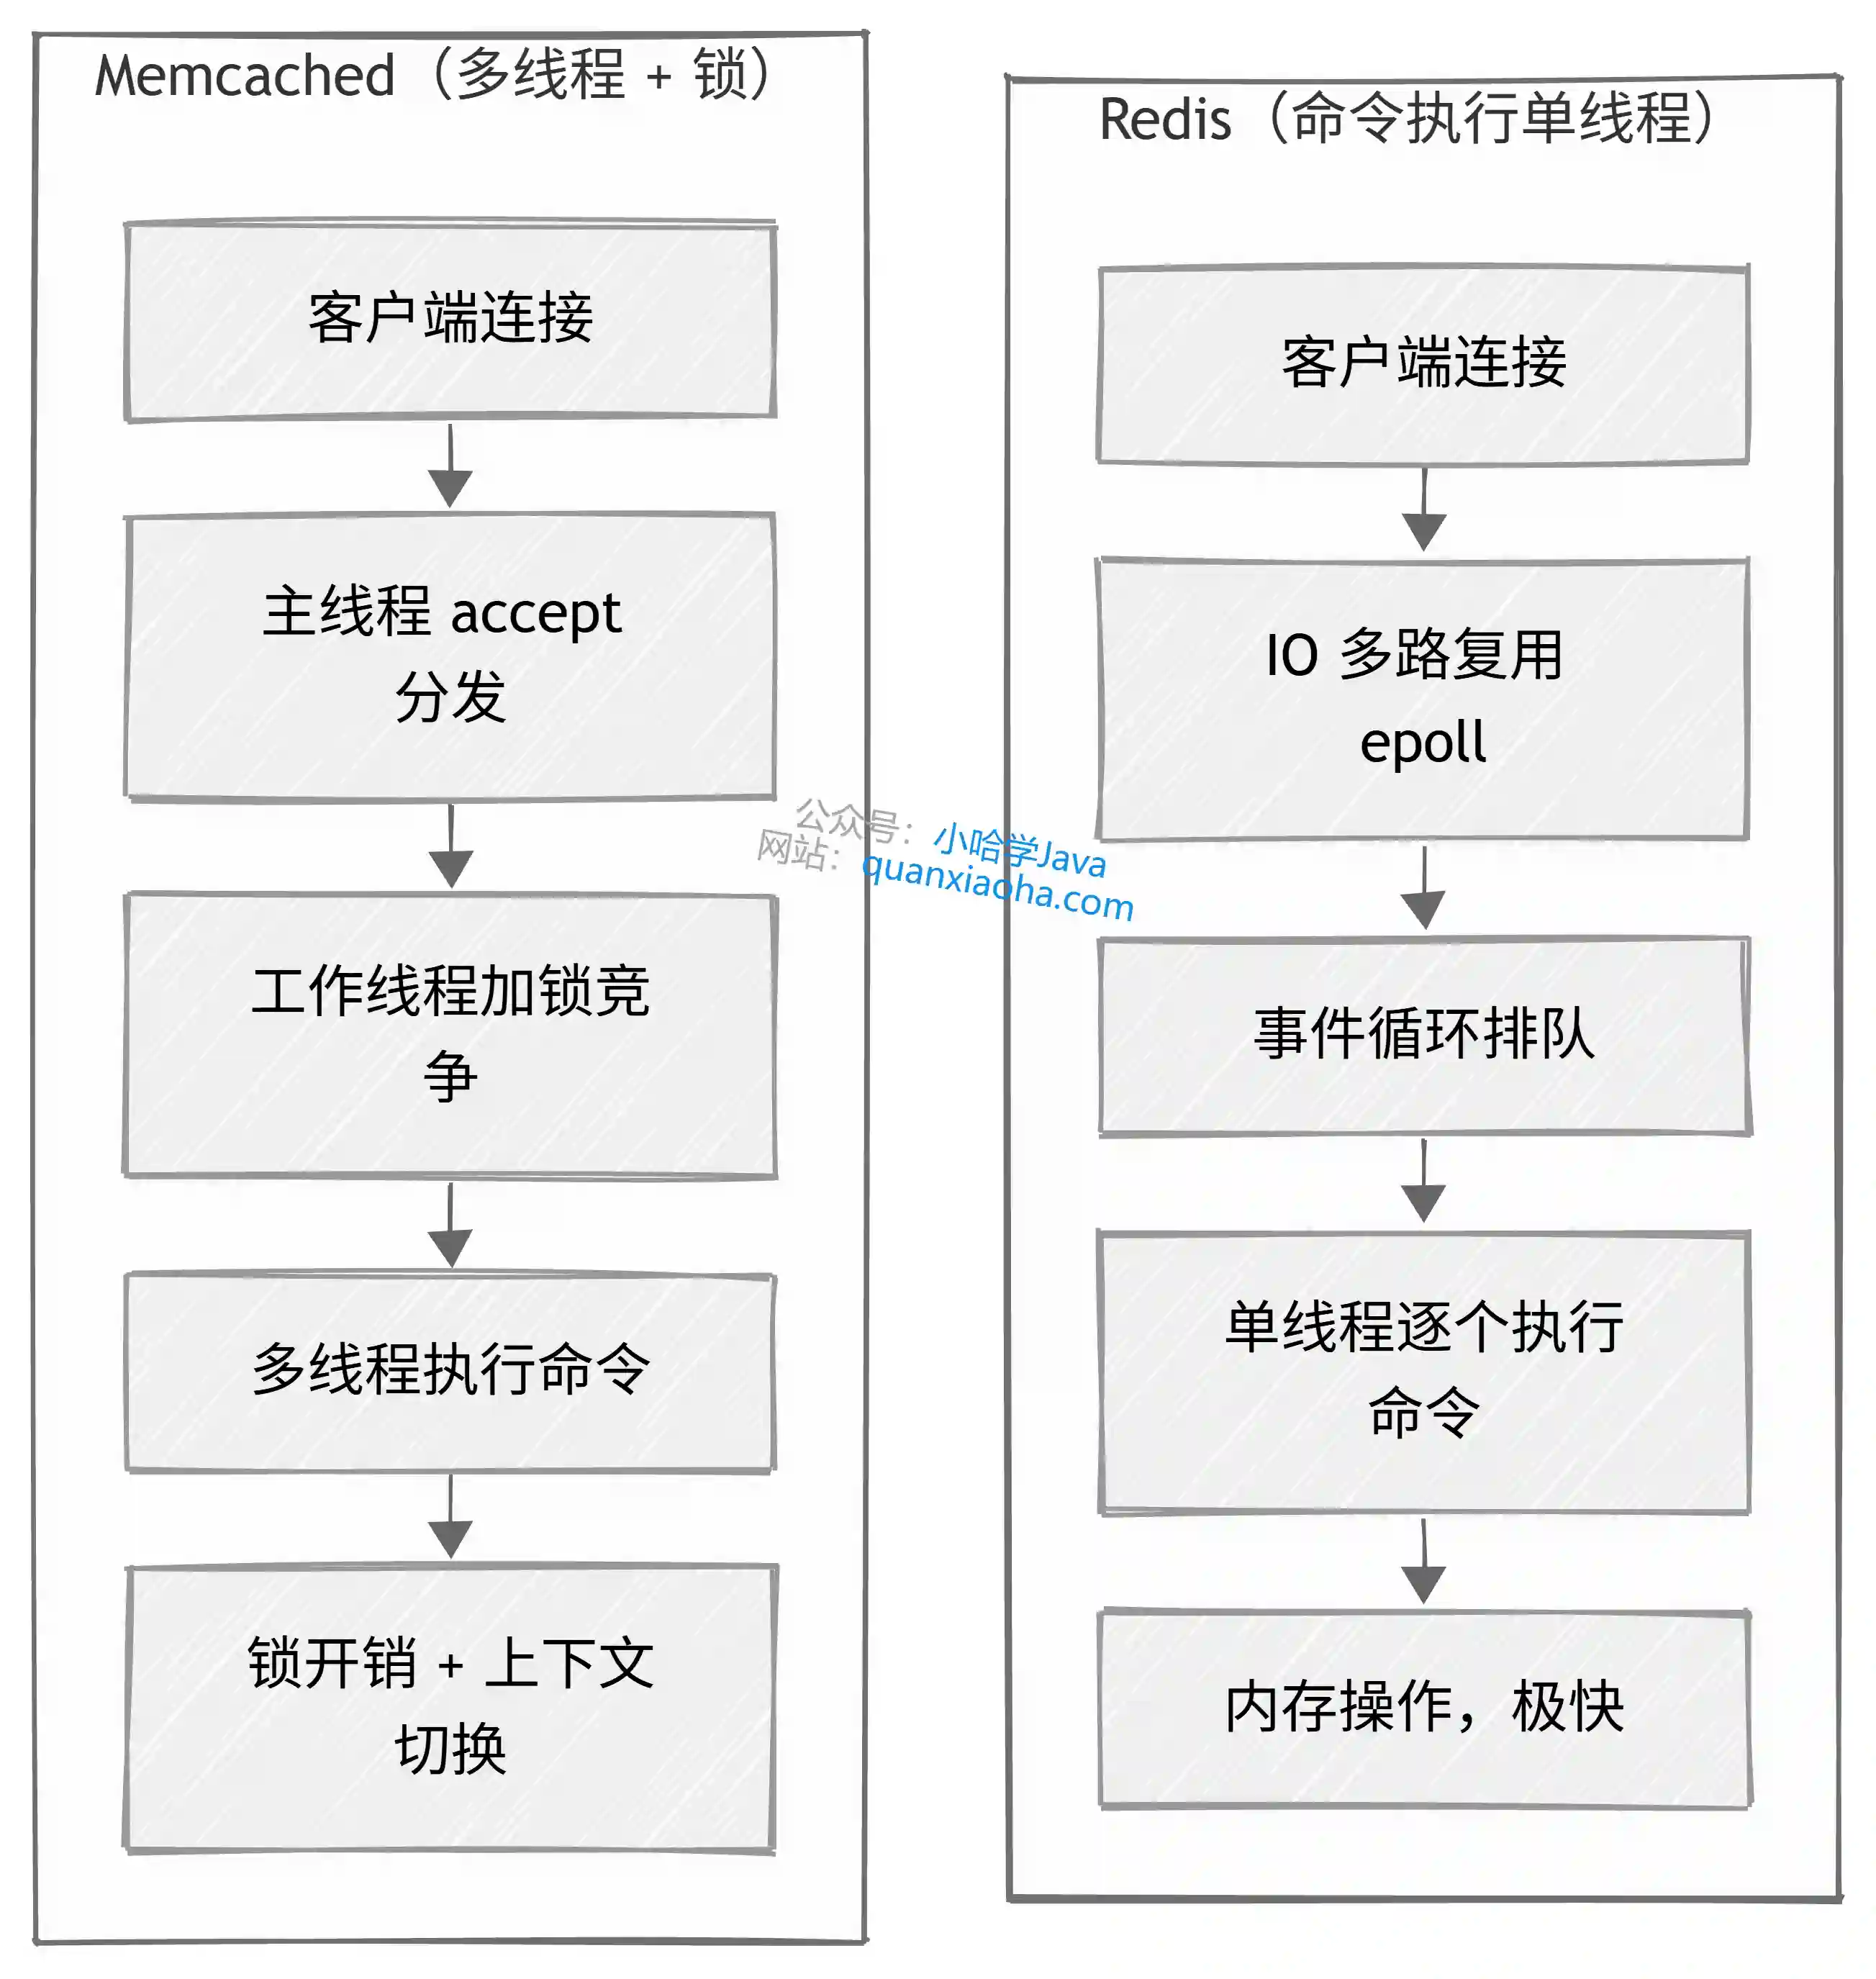
上图是两者线程模型的对比,拆开说:
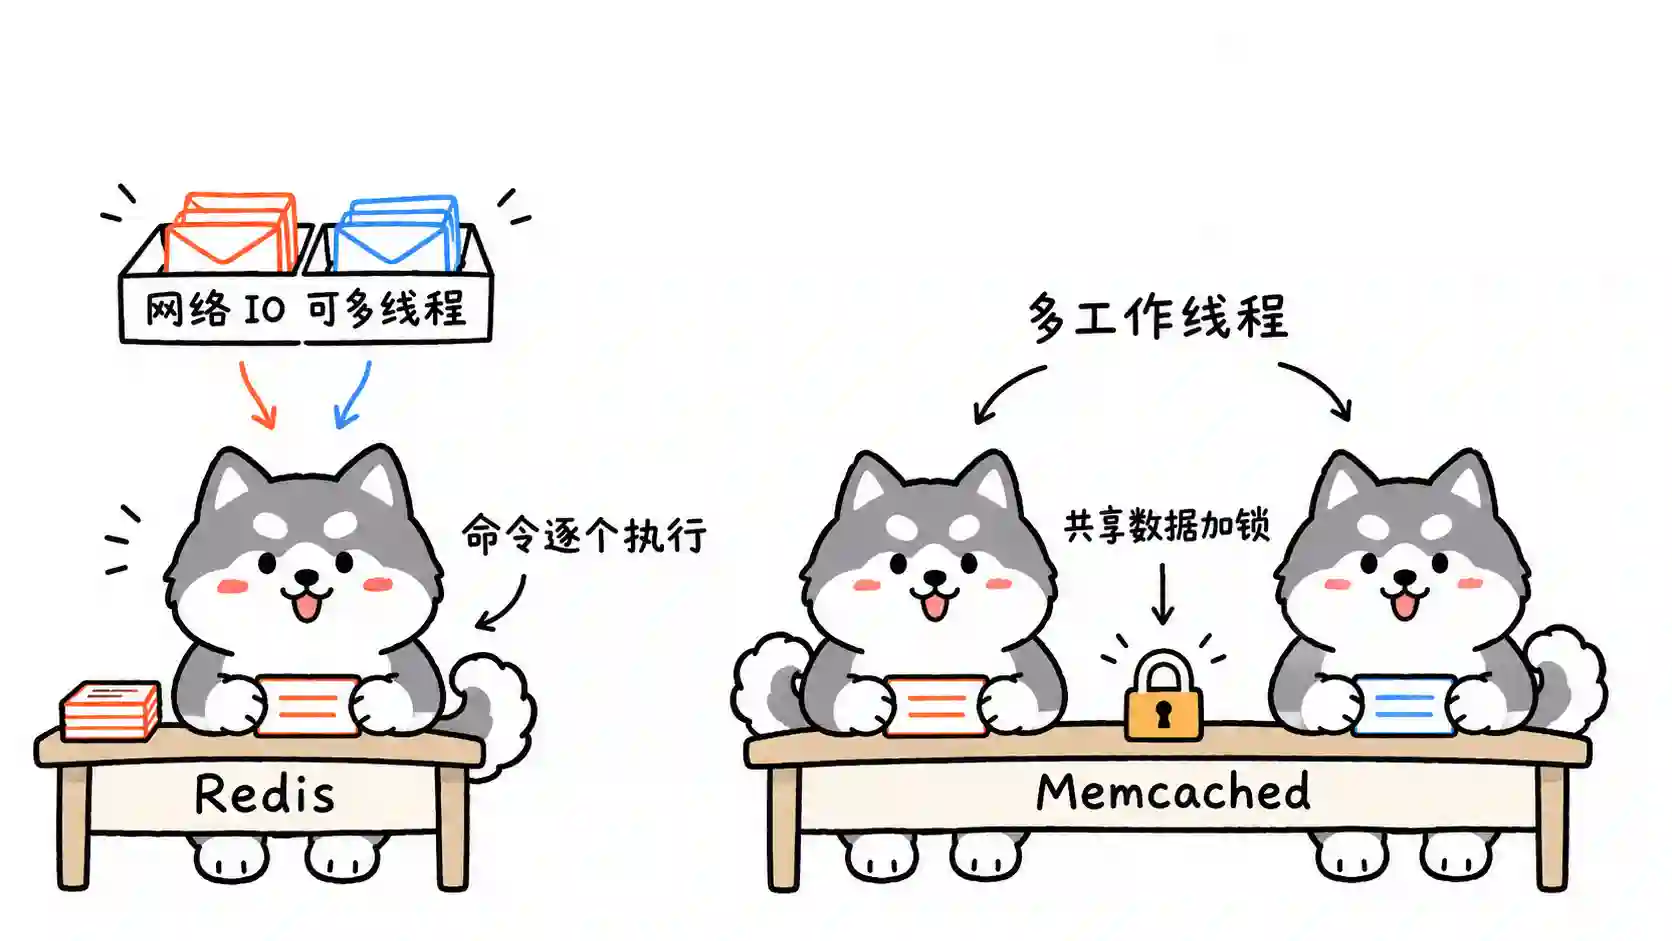
- Redis 的底气来自内存操作:命令执行全是内存读写,单条命令本来就是微秒级。没有锁竞争、没有上下文切换、不用考虑线程安全,实现简单还快。6.0 之前网络 IO 和命令执行都是单线程;6.0 之后网络读写、协议解析拆成了多线程,但命令执行依然是单线程,所以任意时刻还是只有一条命令在跑,原子性有保障。顺便补一句,这个 IO 多线程默认是关着的,得配置
io-threads才会开 - Memcached 的多线程要付锁的代价:主线程负责接收连接,工作线程处理请求,访问共享数据结构得加锁。数据量大了锁竞争和线程切换的开销就上来了
- 真正的瓶颈不在 CPU:缓存场景的瓶颈通常在网络带宽和内存容量,单核打满之前,网卡先顶不住了
实际压测里,小 value、高并发的简单 get/set 场景,两者性能是一个量级,Memcached 在多核机器上甚至略有优势。但在复杂操作上,Redis 的丰富命令让应用层少做好多事,综合效率高得多。
三、内存管理机制
两者的内存管理思路完全不同。
- Redis 用 jemalloc:按大小分类的内存池,能有效减少碎片。另外 Redis 支持设置
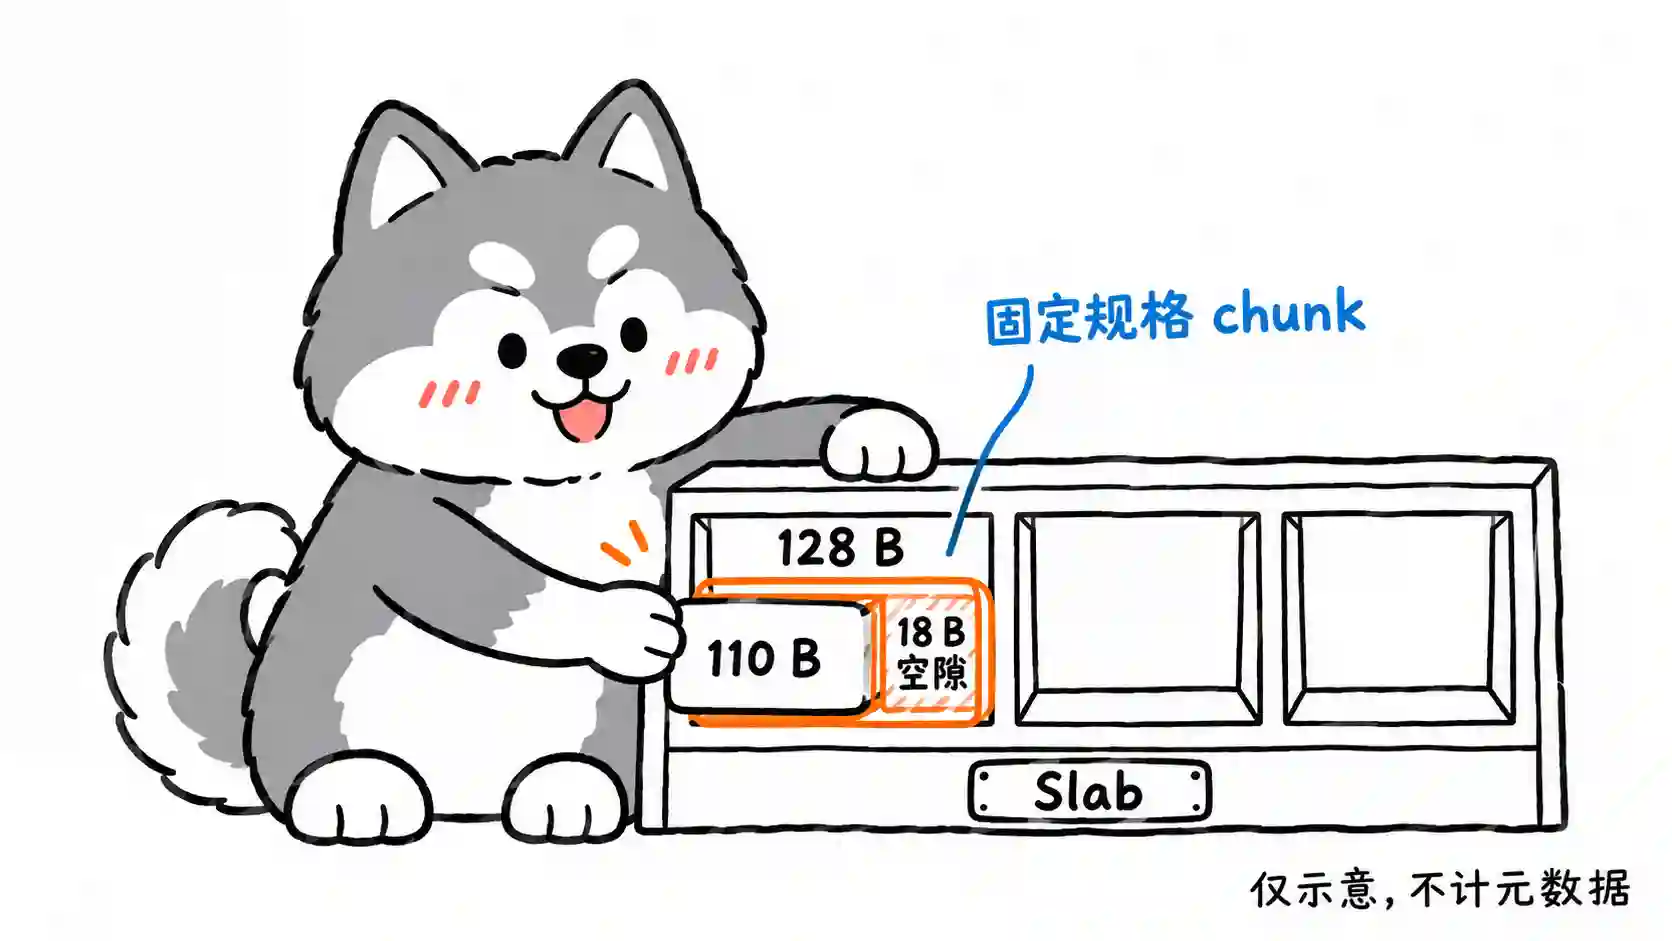
maxmemory,配满了有 8 种淘汰策略可选(noeviction、allkeys-lru、volatile-lru、allkeys-lfu等),冷数据自动腾地方 - Memcached 用 Slab Allocation:预先把内存切成不同规格的 slab class,每个 class 里是固定大小的 chunk。好处是没有 malloc/free 的碎片问题,坏处是空间利用率看运气:你存 110 字节的数据落到 128 字节的 chunk 里,18 字节就浪费了;更极端的情况,item 大小分布不均时会发生“内存还没满,某个 slab class 却分配不到了”,这个坑当年排查过一次,印象深刻
还有一个区别:Memcached 默认按 LRU 整体淘汰,策略单一;Redis 的 LFU(4.0 新增)能按访问频率淘汰,对热点数据更友好。
四、持久化与高可用:生产环境的分水岭
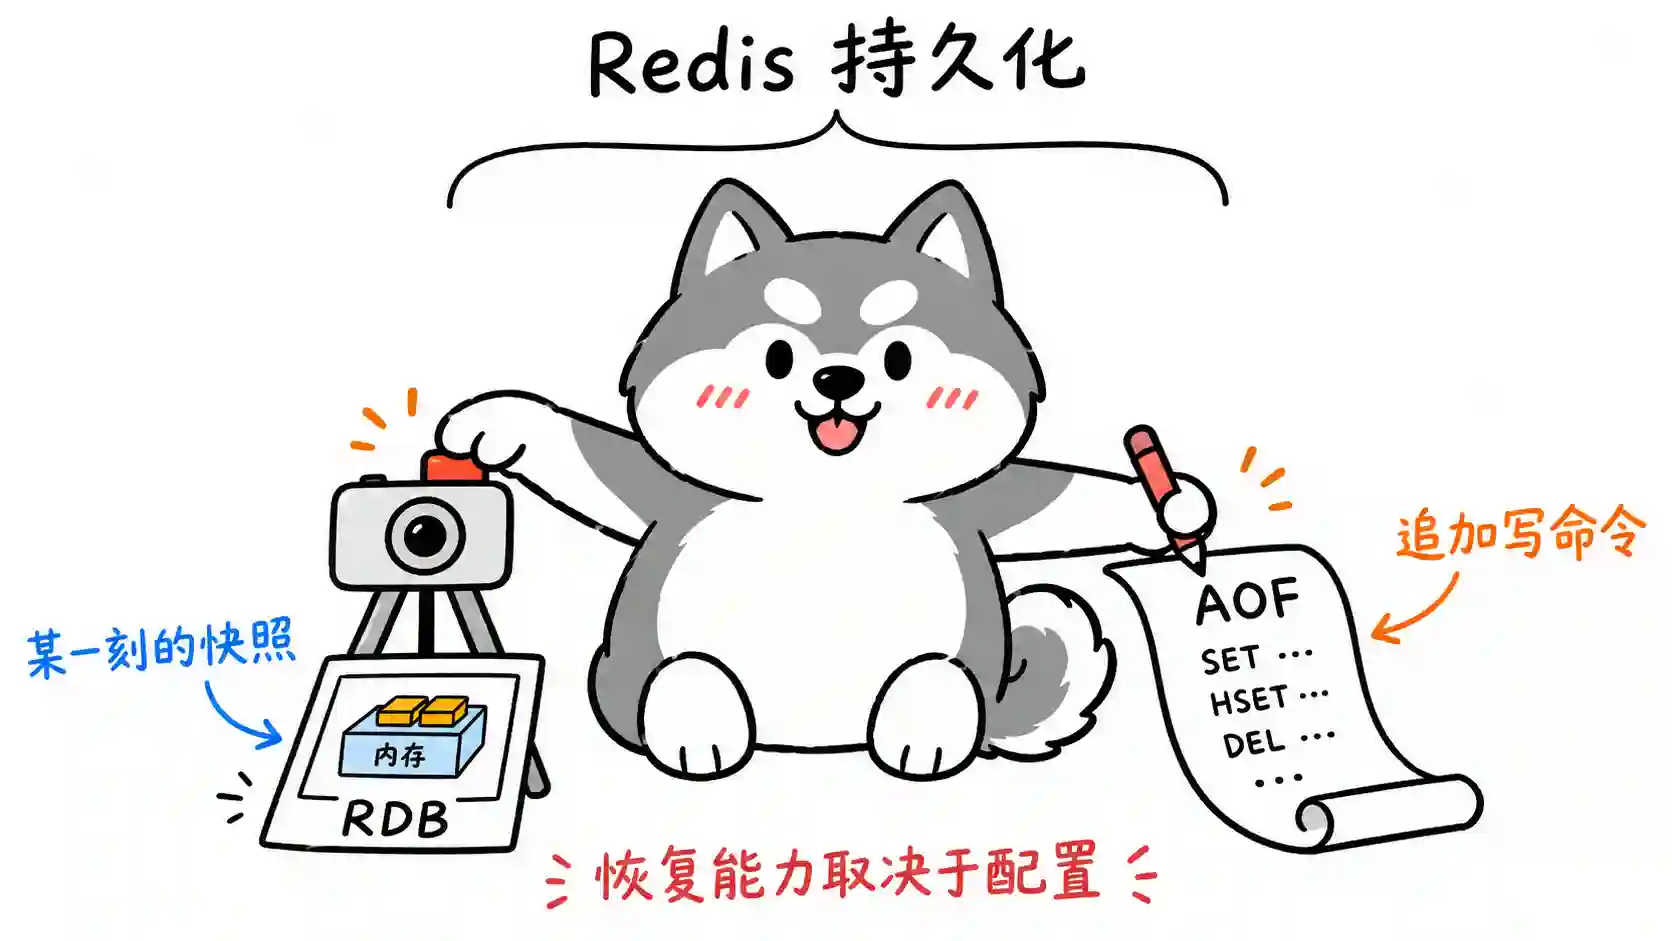
Redis 支持 RDB 和 AOF 两种持久化方式(可以混用):
- RDB:定时快照,二进制压缩,恢复快,但可能丢最近几分钟的数据
- AOF:追加写命令日志,
appendfsync everysec最多丢 1 秒数据
加上主从复制、哨兵(Sentinel)自动故障转移、Cluster 分片(16384 个 slot),Redis 拥有完整的高可用方案。
Memcached 呢?纯内存,不持久化,挂了就挂了,重启全部从零开始;分布式全靠客户端一致性哈希,服务端节点之间互相不认识,更别提故障自动转移了。
来看代码里最直观的对比:
// Redis:可以当轻量级存储用,还能玩丰富结构
@Resource
private StringRedisTemplate stringRedisTemplate;

public void updateScore(String userId, double score) {
    // ZSet 原子加分 + 排序,一条命令搞定
    stringRedisTemplate.opsForZSet().increment("rank:202611", userId, score);
    // 拿 Top 10,还是一条命令
    Set<String> top10 = stringRedisTemplate.opsForZSet()
            .reverseRange("rank:202611", 0, 9);
}

// Memcached:只能存序列化后的字节
MemcachedClient client = ...;
// 想更新排行榜?把整个 list 拉下来、改完、序列化、塞回去
byte[] bytes = client.get("rank");
List<ScoreEntry> list = deserialize(bytes);
// ... 应用层排序、更新、再序列化
client.set("rank", 3600, serialize(list));
同样的业务,Redis 是一条网络命令的事,Memcached 要走三步还有并发覆盖风险。所以现在新项目里基本见不到 Memcached 了。
五、选型建议
别一刀切,按场景来:
- 选 Redis:要丰富数据结构、要持久化、要高可用、要订阅发布。现在 95% 以上的场景闭眼选它
- 选 Memcached:纯 KV、value 小且统一、读多写少、只要极致简单,比如页面片段缓存、session 存储这种单一用途,Memcached 多线程模型在多核机器上跑海量小请求依然能打
面试高频追问
-
追问一:Redis 6.0 为什么引入多线程?命令执行还是单线程吗?
引入多线程是为了提升网络 IO 性能(读写 socket、解析协议),因为瓶颈在网络而不在命令执行。命令执行依然单线程,保证原子性。
-
追问二:Redis 为什么快?
纯内存操作 + IO 多路复用(epoll)+ 单线程避免锁竞争和上下文切换 + 高效的数据结构(跳表、压缩列表、整数集合等按场景优化)。
-
追问三:缓存穿透、击穿、雪崩怎么防?
穿透用布隆过滤器或空值缓存,击穿用互斥锁或逻辑过期,雪崩通过过期时间加随机值和集群高可用来防。
-
追问四:一致性哈希是什么?解决什么问题?
解决普通余数哈希在节点增减时大量 key 重新映射的问题,通过哈希环 + 虚拟节点把影响范围缩到最小,Memcached 客户端分布式和 Redis 分片场景都会用到。
常见面试变体
- “为什么你们项目选 Redis 而不是 Memcached?”
- “Redis 单线程为什么还这么快?”
- “Redis 集群方案了解哪些?”
记忆口诀
“Redis 全家桶,Memcached 一根筋”——数据结构全家桶、持久化、高可用、事务 Lua,Redis 全都有;Memcached 就一根筋:纯内存 KV 缓存,简单粗暴。
总结
一句话:Redis 是功能齐全的内存数据库,Memcached 是纯粹的分布式缓存。数据结构、持久化、高可用这三条主线上 Redis 全面领先,新项目默认选 Redis;Memcached 只在极致简单的纯 KV 场景还有价值。把两者定位差异讲清楚,再带出单线程模型和内存管理的细节,这道题就答到位了。