Redis 单线程,为什么还这么快?
一则或许对你有用的小广告
欢迎加入小哈的星球,你将获得:专属的实战项目(4个项目都能学) / 1v1 提问 / 简历修改 / Java 学习路线 / 社群讨论 / 学习打卡 / 每月赠书
《Spring AI 项目实战(问答机器人、RAG 智能客服、联网搜索)》已完结,基于
Spring AI + Spring Boot 3.x + JDK 21...,查看介绍《从零手撸:仿小红书(微服务架构)》 已完结,基于
Spring Cloud Alibaba + Spring Boot 3.x + JDK 17...,查看介绍;演示链接:http://116.62.199.48:7070/《从零手撸:前后端分离博客项目(全栈开发)》 2 期已完结,演示链接:http://116.62.199.48/
新开坑项目:《从零手撸:秒杀系统高并发优化实战》 正在更新中...,查看介绍
截止目前,星球内专栏累计输出 150w+ 字,讲解图 5110+ 张,还在持续爆肝中.. 后续还会上新更多项目,已有 4700+ 小伙伴加入学习,欢迎点击围观
面试考察点
-
线程模型的准确理解:面试官不仅仅想知道你会不会背 “纯内存 + IO 多路复用” 这套说辞,更想知道你是否清楚 “单线程” 到底指什么。命令执行是单线程,但整个进程可不是只有一个线程。这层区别,直接区分 “背题的” 和 “理解的”。
-
高性能原理的拆解能力:Redis 快是结果,面试官要看的是你能不能把 “快” 拆成内存、IO 模型、线程模型、数据结构这几个维度,逐个说清楚因果链,而不是一股脑堆名词。
-
版本演进意识:Redis 6.0 引入多线程 IO 是近几年面试的高频考点,答不出来说明知识更新停在几年前了。
核心答案
先上结论,Redis 快的原因可以归纳成 5 点:
| 序号 | 原因 | 一句话概括 |
|---|---|---|
| 1 | 纯内存操作 | 读写走内存,不碰磁盘,速度差好几个数量级 |
| 2 | IO 多路复用 | 一个线程监听成百上千个连接,epoll 事件驱动不空等 |
| 3 | 单线程无锁竞争 | 没有锁、没有线程上下文切换,天然串行免加锁 |
| 4 | 高效的数据结构 | SDS、跳表、ziplist 全是为内存场景特调过的 |
| 5 | 多线程 IO(6.0+) | 网络读写并行化,命令执行依旧单线程 |
有个普遍误解得先说清楚:“单线程” 指的是处理客户端命令请求的那个核心线程是单个,不是说整个 Redis 进程只有一个线程。后台还有专门负责关闭文件、AOF 刷盘、异步删除的辅助线程。这个澄清放在回答开头,是加分项。
深度解析
一、先澄清:Redis 真的是单线程吗?
严格来说,Redis 的 “单线程” 是有边界的:
- 核心线程只有一个:接受请求、解析命令、执行命令、返回结果,这条主链路从头到尾都是同一个线程(主线程)在干活。我们平时说 “Redis 是单线程”,指的就是它。
- 后台线程不止一个:从 2.6 版本起,Redis 就有后台线程(bio 线程)了,一开始有 2 个,负责关闭文件描述符、AOF 刷盘(
fsync)这两类慢操作;4.0 又加了第 3 个,专门负责异步删除(UNLINK、FLUSHALL ASYNC这些)。这些活儿又慢又不碰核心数据结构,扔给后台线程干,主线程就能一直保持轻盈。 - Redis 6.0 之后还有 IO 线程:专门处理网络读写和协议解析,下面细说。
所以更准确的说法是:Redis 的命令执行是单线程的,但整个进程是多线程协作的。
二、纯内存操作,这是快的根基
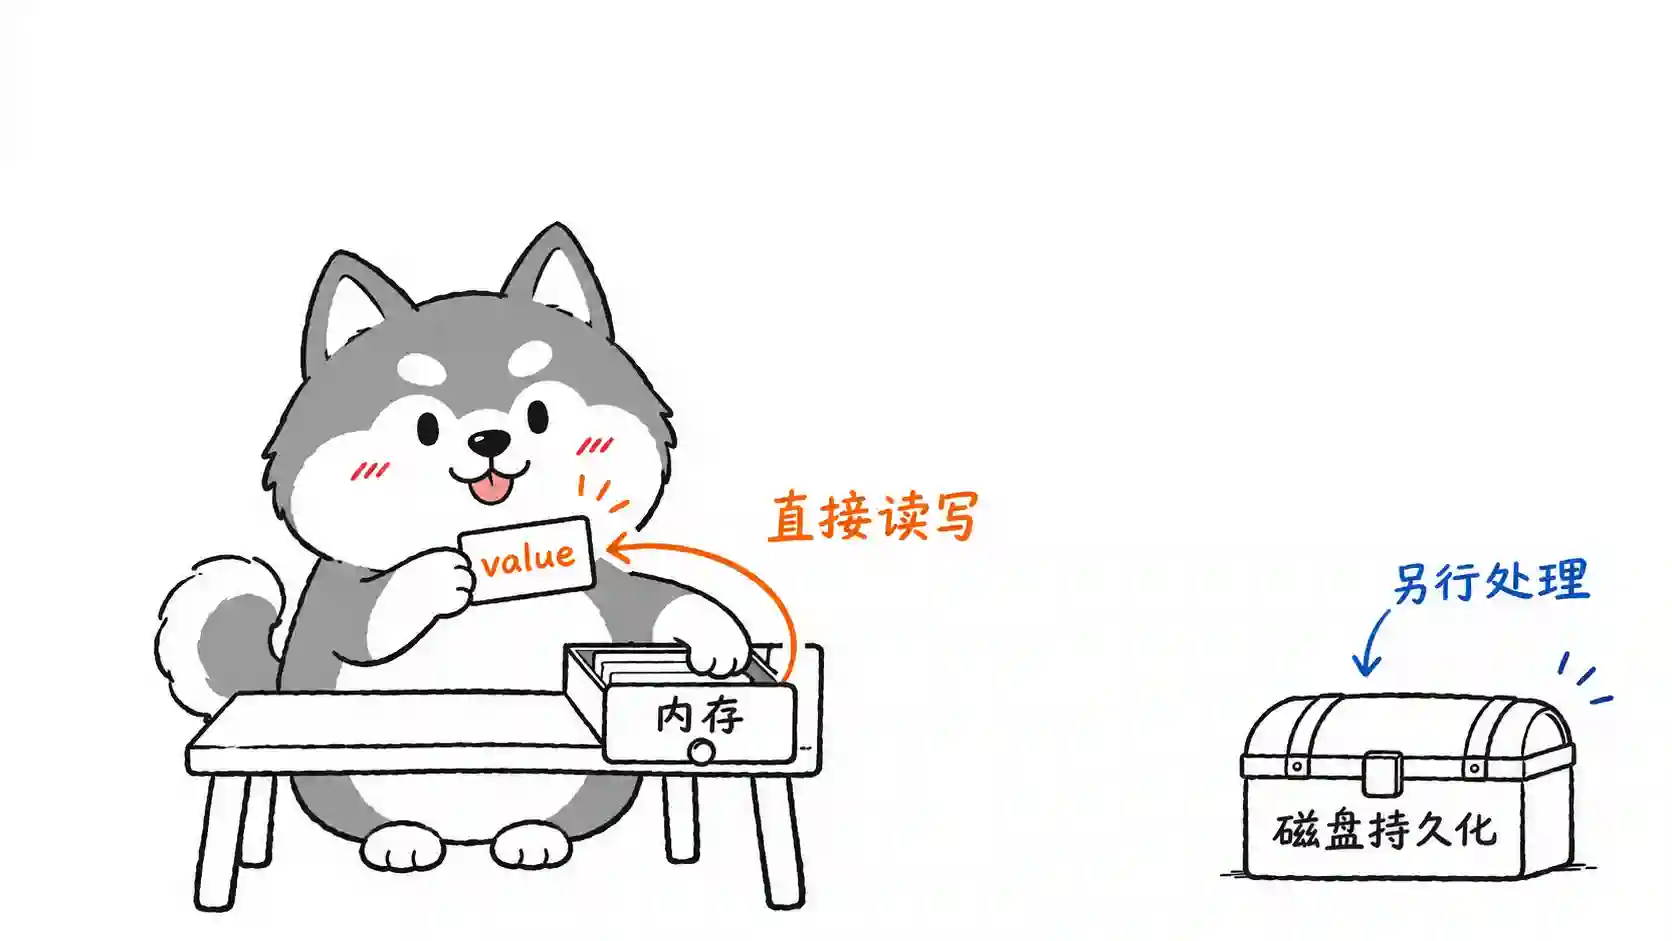
Redis 的所有数据都放在内存里,读写直接操作内存。内存和磁盘的速度差距是碾压级的:
| 存储介质 | 随机访问延迟 | 大致对比 |
|---|---|---|
| 内存(DRAM) | 约 100 纳秒 | 基准 |
| SSD 磁盘 | 约 100 微秒 | 慢 1000 倍 |
| 机械硬盘 | 约 10 毫秒 | 慢 10 万倍 |
像 MySQL 这类基于磁盘的数据库,一次查询要走索引定位、磁盘寻址、加载页到 Buffer Pool,链路长得很。Redis 直接砍掉了磁盘 IO 这一段,一次命令的耗时压到微秒级。官方给的性能参考是单实例可达 10 万+ QPS,实际压测中跑到二三十万也不稀奇。
当然,持久化(RDB、AOF)还是会碰磁盘,但那是异步的、可配置的,不影响主流程的读写性能。
三、IO 多路复用:一个线程怎么同时服务几万个连接
这是这道题真正的核心,也是面试官最想听的部分。
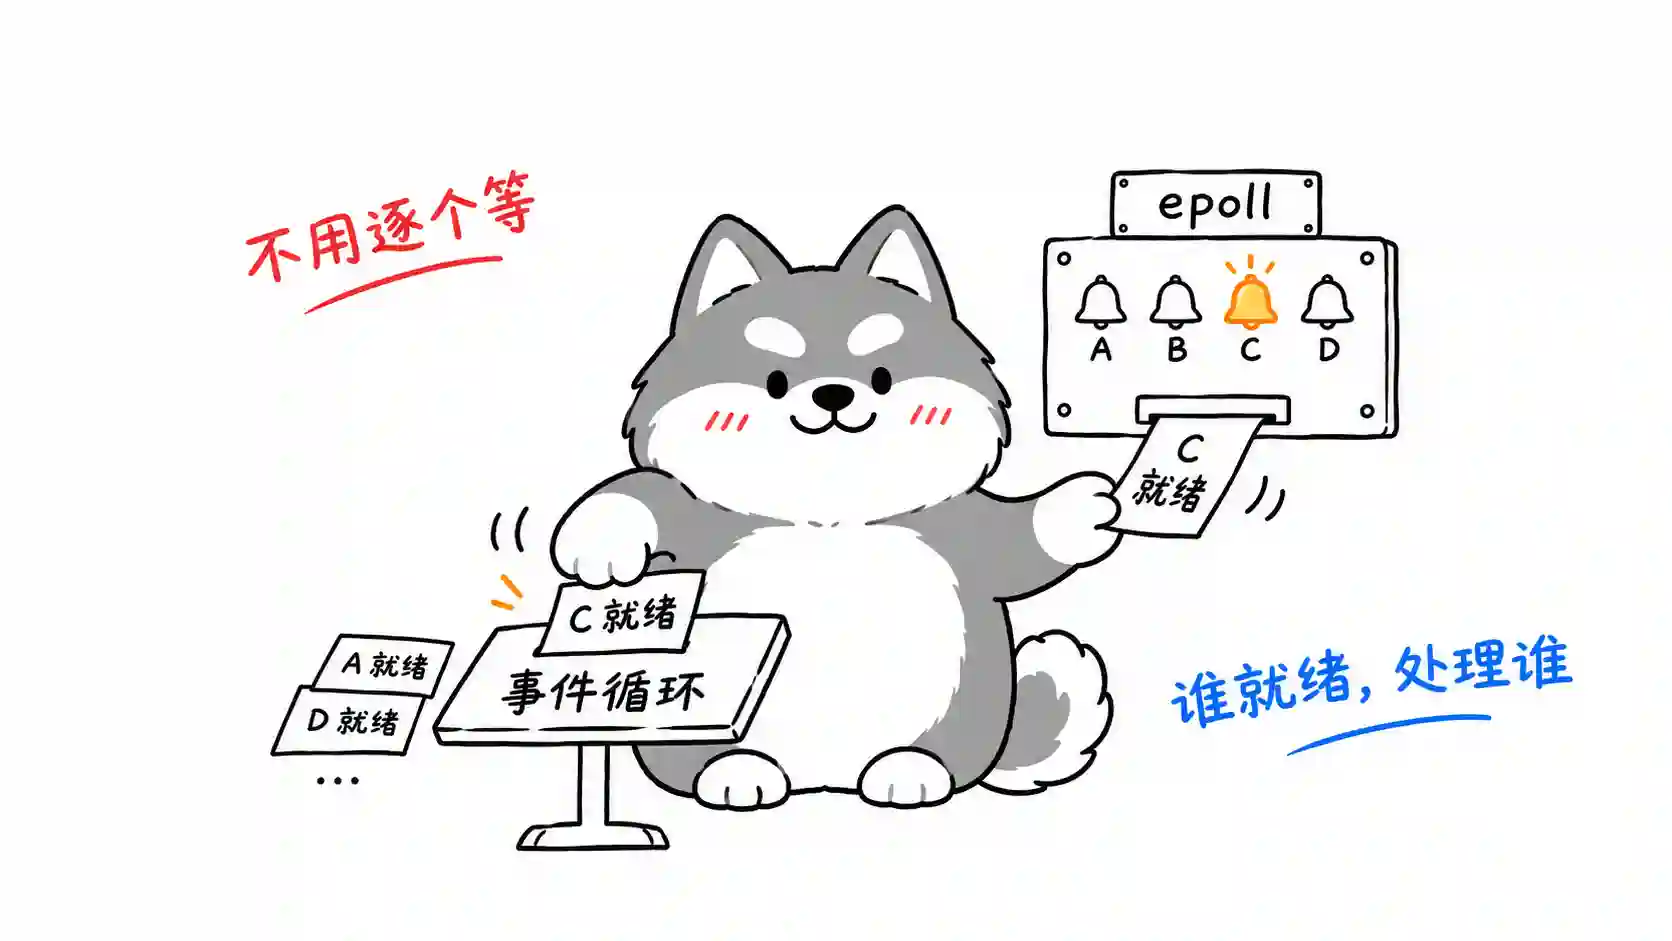
打个比方:一个服务员(主线程)要招待一整条街的客人(客户端连接)。笨办法是一个客人一个服务员(线程/进程模型,比如 Apache 的 prefork),人多了直接把系统资源耗干。聪明办法是装一个呼叫铃(epoll),哪个桌按铃就去看哪桌,一个服务员就能从容应付几百桌。
Redis 里这套机制叫 文件事件处理器(file event handler),基于 Reactor 模式实现:
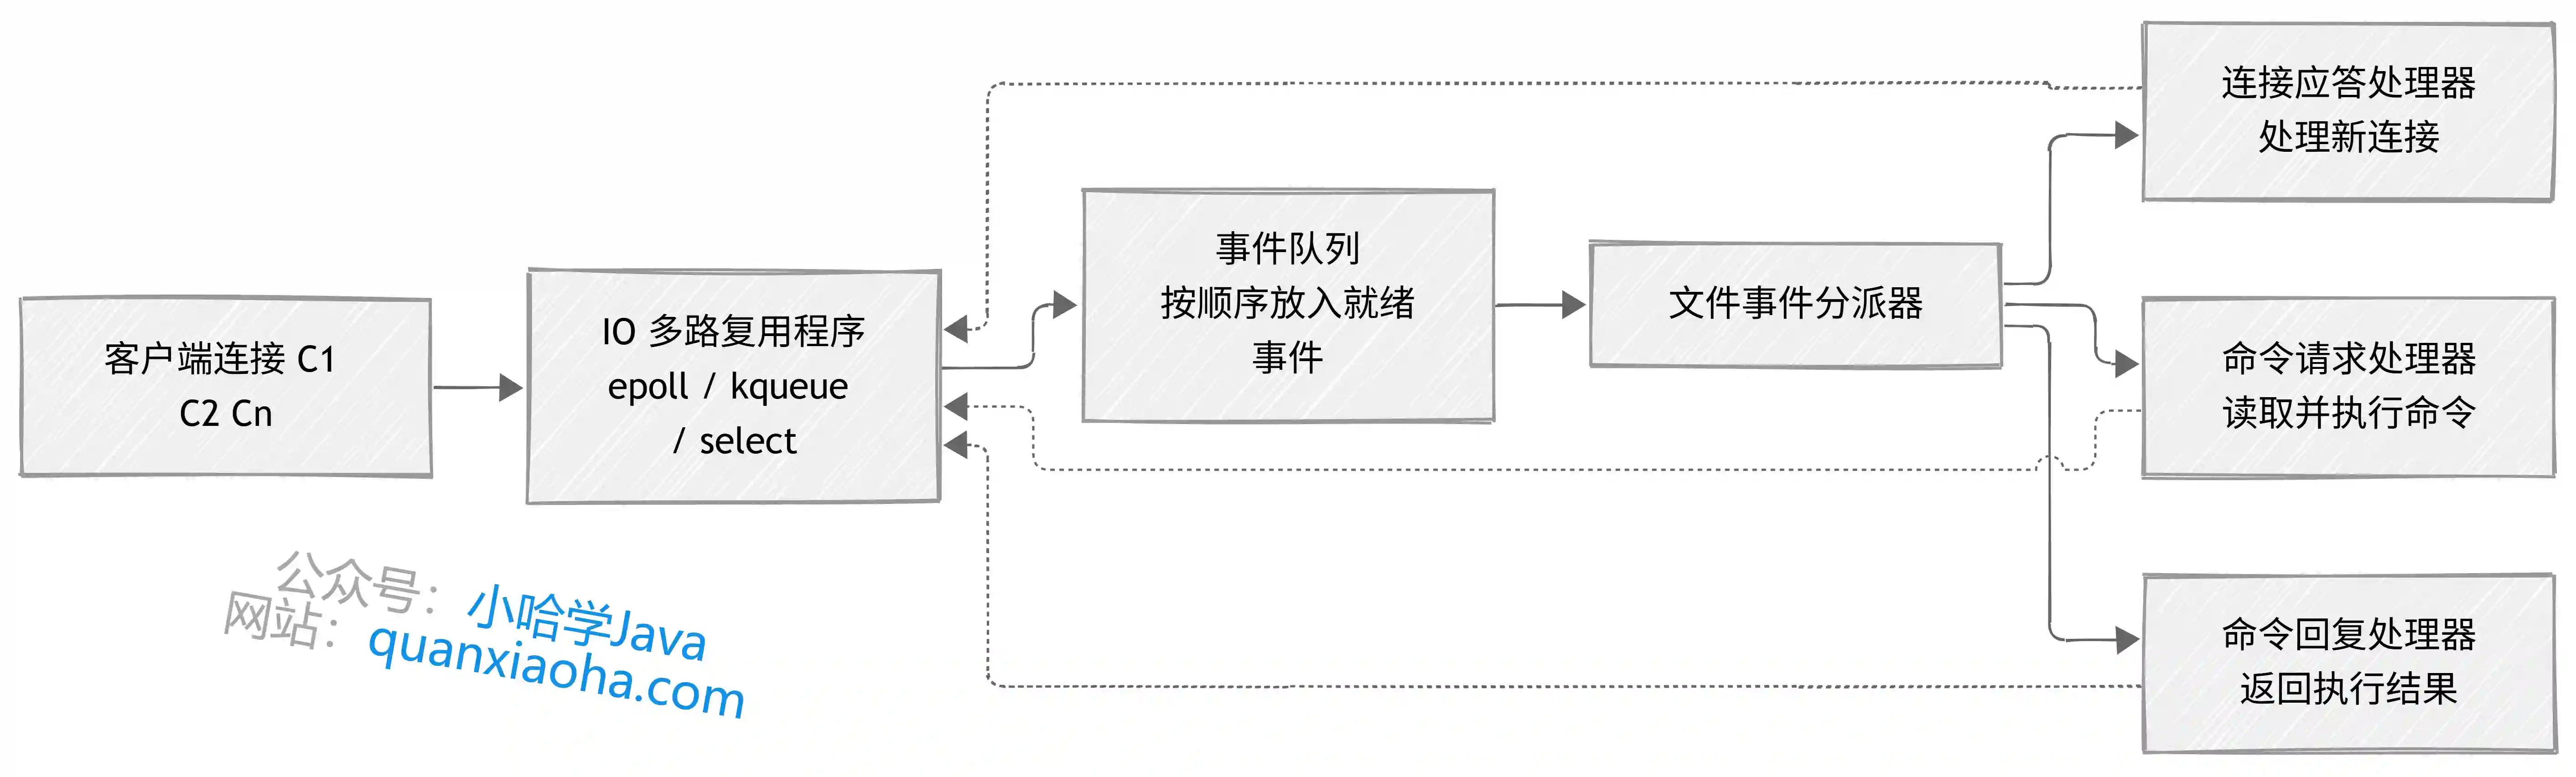
拆开来看这个流程:
- IO 多路复用程序:Linux 上用的是
epoll(BSD/macOS 上是kqueue),它可以同时监听大量 socket 的读写事件。哪个连接有数据到了,epoll就通知哪个,线程不用干等。epoll相比老一代select的优势是:随着监听的 fd 数量增加,性能不会线性下降,几万个连接也能稳住。 - 事件队列:多个连接同时就绪时,事件会先排队,保证一个一个处理,顺序确定。
- 文件事件分派器:根据事件类型,把事件分给对应的处理器。新连接来了给 “连接应答处理器”,客户端发命令了给 “命令请求处理器”,该回结果了给 “命令回复处理器”。
- 处理器干活:所有处理器都在同一个主线程里执行,处理完一个事件再取下一个,循环往复(事件循环,event loop)。
一句话总结:IO 多路复用让单线程也能 “同时” 服务海量连接,非阻塞 + 事件驱动,CPU 一刻都不闲着。
四、单线程不是缺陷,反而是优势
很多人下意识觉得单线程 = 慢,恰恰相反,在 Redis 的场景里这是刻意的选择:
- 没有锁竞争:所有命令串行执行,天然线程安全,不需要任何锁。想想 Java 里
ConcurrentHashMap为了减少锁竞争做了多少复杂设计,Redis 直接一劳永逸。 - 没有线程上下文切换的开销:多线程场景下,CPU 在线程之间来回切换,每次切换都要保存和恢复现场,这个开销在高频操作下很可观。单线程直接省了。
- 实现简单,可维护性强:数据结构不需要考虑并发修改,代码清晰,bug 少,对基础软件来说这点很值钱。
前提是:Redis 的操作全是内存操作,本来就快,瓶颈在网络 IO 而不在 CPU 计算。既然单个线程就能把内存的潜力榨干,要啥自行车?
五、高效的数据结构,专治各种场景
Redis 底层数据结构不是拿通用的直接凑合,全是自己手写、针对内存和性能特调的:
| 数据结构 | 用在哪 | 快在哪 |
|---|---|---|
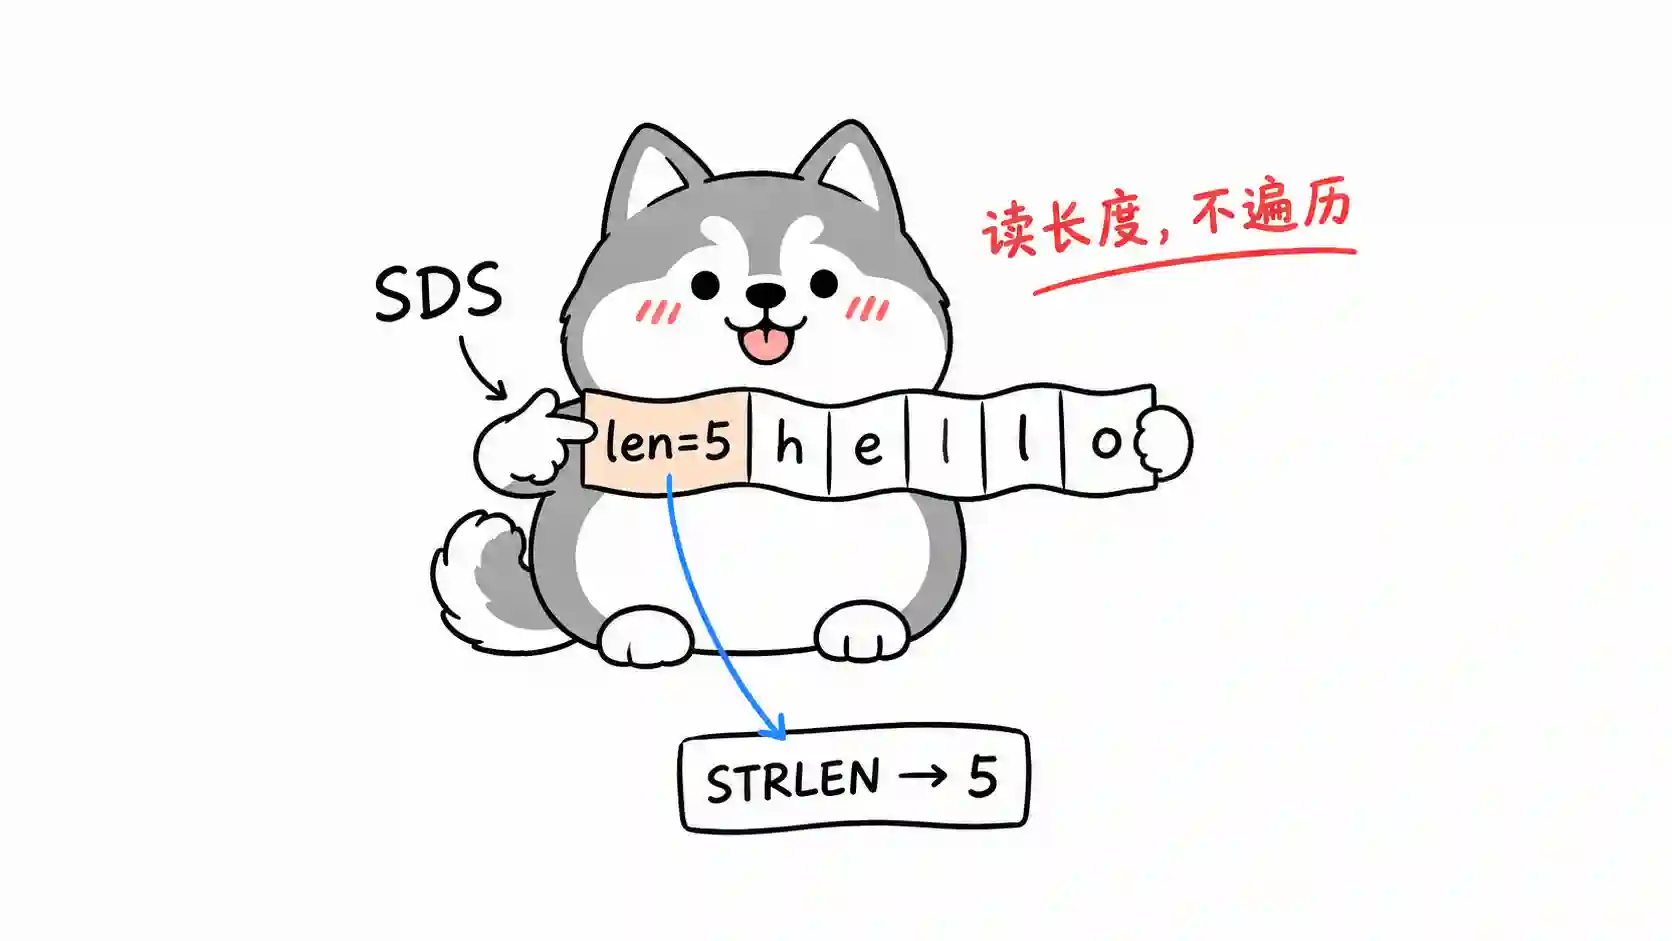
| SDS(简单动态字符串) | String 的底层 | 预分配 + 惰性释放,改字符串不用反复分配内存;头部直接记录长度,STRLEN 是 O(1) |
| 跳表(skiplist) | ZSet 的底层之一 | 平均 O(log N) 的增删查,范围查询友好,实现比红黑树简单得多 |
| ziplist/listpack | 小数据量的 Hash、List、ZSet | 一段连续内存,元素少时极其省空间、访问快 |
| quicklist | List 的底层 | ziplist 的双向链表,兼顾内存和效率 |
举个细节:C 语言原生字符串获取长度要 O(n) 遍历,SDS 在头部存了 len 字段,读长度直接返回,这就是 “为性能特调” 的味道。
六、Redis 6.0 的多线程 IO:补上最后一块短板
命令执行快归快,但随着硬件升级,网络读写和协议解析逐渐成了新瓶颈。于是 Redis 6.0 引入了多线程 IO:
# redis.conf 中开启多线程 IO(默认关闭,io-threads 为 1 时就是单线程)
io-threads 4            # IO 线程数,必须大于 1 才会启用;官方建议 4 核设 2~3,8 核最多设 6 左右,别超过 CPU 核数
io-threads-do-reads no  # 多线程读默认关闭,官方建议保持默认
注意这里的精髓:
- 多线程只管网络 IO 这摊活儿:读取 socket 数据、解析协议、写回响应。这些可以并行。
- 命令执行依然是单线程:所有命令还是由主线程串行执行,所以不存在并发执行带来的数据竞争问题,之前 “单线程” 的所有好处一点没丢。
这波设计很 Redis:哪里有瓶颈就优化哪里,核心的简单性绝不牺牲。
面试高频追问
-
追问:单线程有什么坏处?怎么规避?
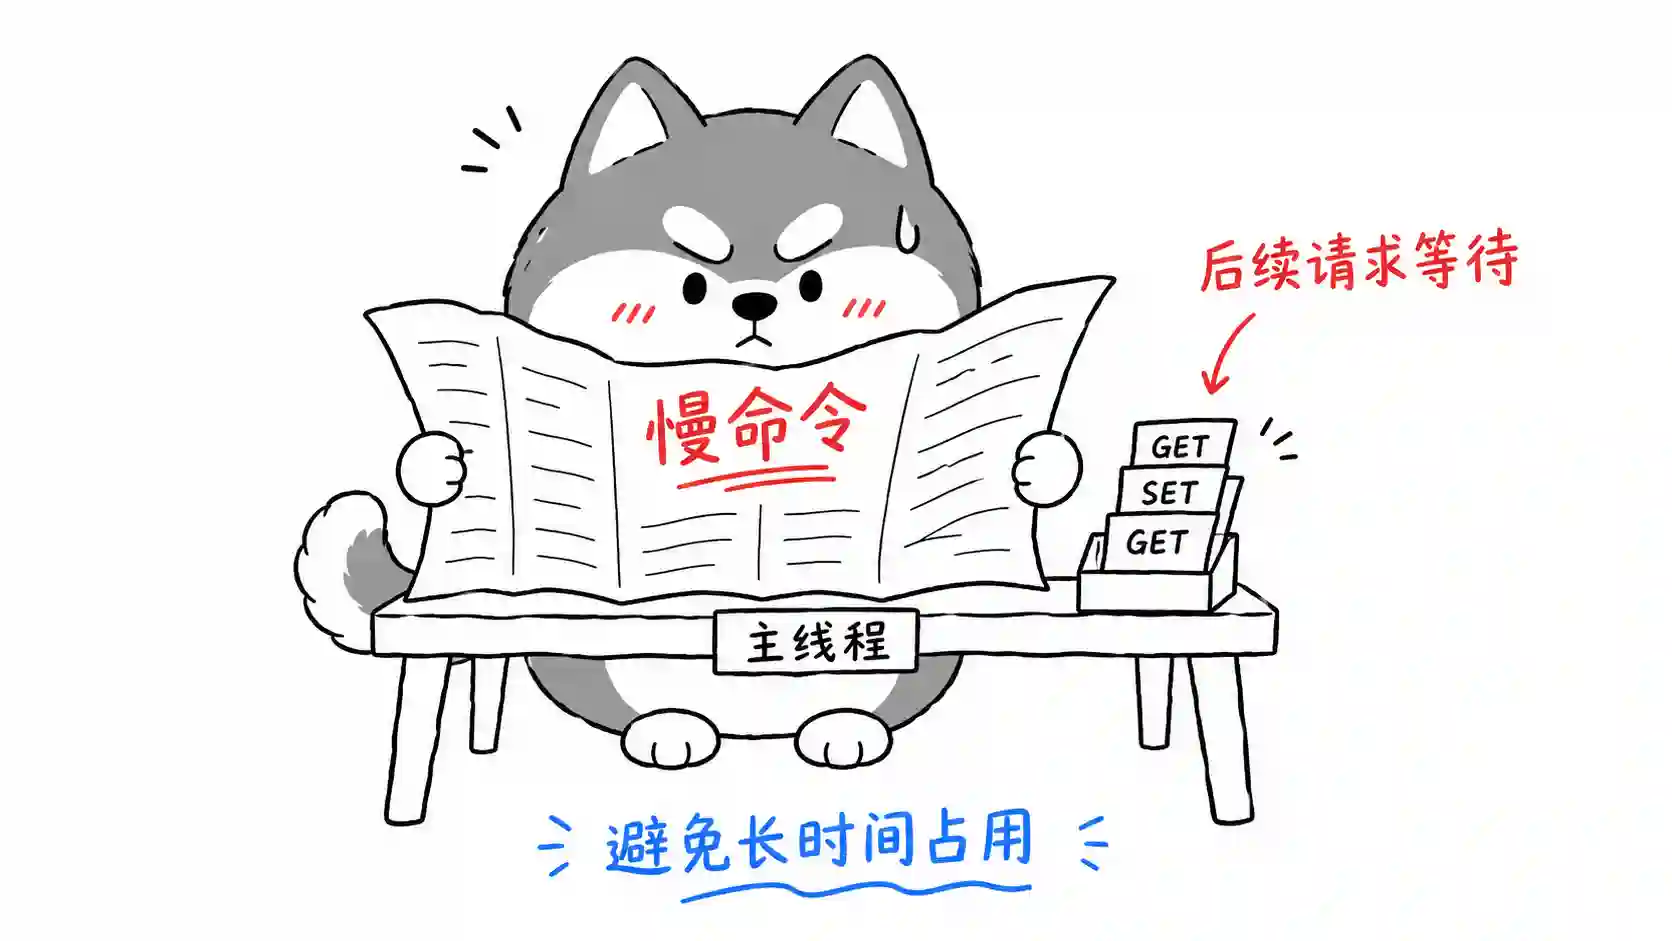
最大的问题是:一个慢命令会阻塞后面所有命令。比如在生产上执行
KEYS *,百万级 key 直接卡死主线程,整个 Redis 假死。规避手段:用SCAN代替KEYS,删大 key 用UNLINK代替DEL,规避smembers这类大集合命令。这个问题几乎必追问。
-
追问:bigkey 是什么?有什么危害?
bigkey 指 value 特别大的 key,比如几百万元的集合。危害就是阻塞主线程、网络拥塞、内存分布不均、删除时引发卡顿。排查用
redis-cli --bigkeys。 -
追问:既然这么快,为什么还需要 pipeline?
单条命令的瓶颈往往不在 Redis 执行,而在网络往返(RTT)。pipeline 把一批命令打包、一次发送、一次接收,省掉的是网络 IO 的等待时间,吞吐量能翻好几倍。
-
追问:Redis 6.0 都引入多线程了,以后会不会全面多线程化?
不会。官方态度很明确:多线程只用于网络 IO,命令执行的串行化保证了简单性和原子性,这是 Redis 的立身之本。目前的发展方向是把耗时操作继续剥离到后台线程。
常见面试变体
- 变体一:“Redis 6.0 之前,真的是完完全全的单线程吗?”(考察后台线程的存在)
- 变体二:“讲讲 Redis 的 IO 多路复用,和 Nginx、Netty 里的有什么相通之处?”(考察 Reactor 模型的横向理解,Netty 也是这个套路,可以顺势引导话题)
- 变体三:“单线程的 Redis 为什么能跑到 10 万 QPS?”(同一道题换个数字马甲)
记忆口诀
一内存,二多路,三无锁,四结构,6.0 补网 IO。内存打底,epoll 开路,单线程免锁,数据结构特调,6.0 用多线程补网络短板。
总结
Redis 快,是 “内存操作 + IO 多路复用 + 单线程无锁 + 特调数据结构” 四者叠加的结果,6.0 的多线程 IO 又把网络这最后一块短板补上了。回答时先澄清 “单线程指命令执行”,再拆维度逐个讲,最后主动提一句 KEYS * 的危害把话题引向慢查询,这道题基本就稳了。